记忆后端——记忆存在哪里
Hermes 功能详解第5篇:记忆提供方。内置记忆、Honcho、各种记忆后端任你选。
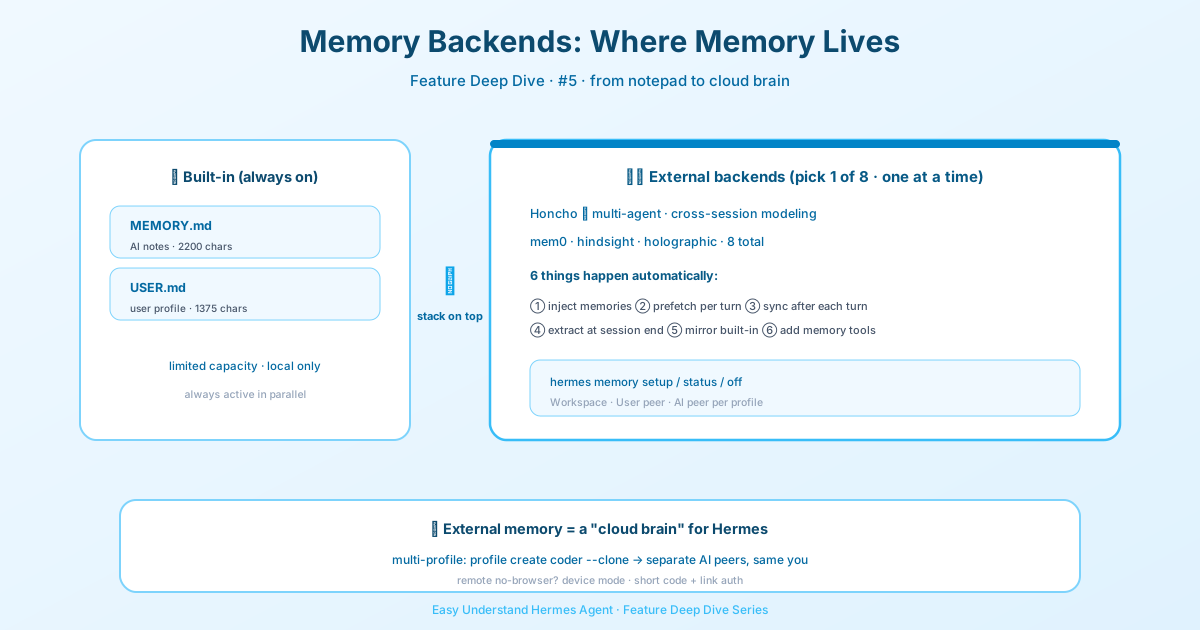
記憶後端——記憶存在哪裡
嘿,朋友們!前面幾篇我們聊了 Hermes 的記憶檔案(MEMORY.md 和 USER.md),那是它的「內建筆記本」。但今天要聊的是外掛記憶庫——當內建筆記本不夠用,你想讓 Agent 記住跨 session、甚至跨使用者的長久記憶時,就該請出這 8 位「外援」了。
一句話理解
內建記憶(MEMORY.md / USER.md)永遠在線,而外部記憶提供者是疊加上去的。同一時間只能啟用一個外部提供者,但內建的照常運作,互不干擾。
三秒上手
hermes memory setup      # 互動式選擇 + 設定
hermes memory status     # 查看目前啟用的是誰
hermes memory off        # 關閉外部提供者
不想敲指令?也可以去 hermes plugins → Provider Plugins → Memory Provider 裡點選。或者直接改設定檔 ~/.hermes/config.yaml:
memory:
  provider: honcho   # 或 mem0, hindsight, holographic, retaindb, byterover, supermemory, openviking
啟用後會發生什麼?
一旦啟用,Hermes 會在背景自動做 6 件事:
- 注入上下文——把提供者知道的關於你的資訊塞進系統提示詞
- 預取記憶——每輪對話前,背景悄悄檢索相關記憶(不阻塞)
- 同步對話——每次回覆後,把對話內容同步給提供者
- 會話結束提取——支援的話,自動提煉長期記憶
- 鏡像寫入——內建記憶的寫入也會同步給外部提供者
- 新增專屬工具——Agent 可以主動搜尋、儲存、管理記憶
重點聊聊 Honcho
8 個提供者裡,Honcho 是文件裡著墨最多的,因為它有個很酷的「辯證法」機制——用 LLM 推理來生成使用者畫像,而不是簡單存文字。
它適合誰? 多 Agent 系統、需要跨 session 理解使用者、講究「人機對齊」的場景。
架構亮點:兩層上下文注入
- 基礎層:會話摘要 + 使用者表徵 + 使用者卡片,按
contextCadence重新整理 - 辯證層:LLM 推理補充,按
dialecticCadence觸發,深度由dialecticDepth控制(1-3 輪)
還有個聰明的小設計:查詢越長,推理越深(有上限 reasoningLevelCap),短問題不浪費算力,長問題深入分析。
三個獨立旋鈕,成本與深度分開調:
contextCadence:基礎層重新整理頻率(API 呼叫頻率)dialecticCadence:辯證層 LLM 觸發頻率(1-5 推薦)dialecticDepth:每次辯證的推理輪數(1-3)
無頭機器部署:SSH 遠端機器沒有瀏覽器?選 device 認證方式,CLI 會印出一個短碼和驗證連結,你在任何有瀏覽器的機器上開啟連結確認即可,不用複製貼上 API key。
設定檔位置(按優先級):$HERMES_HOME/honcho.json > ~/.hermes/honcho.json > ~/.honcho/config.json
小貼士
- 舊指令
hermes honcho setup還能用,但會重新導向到hermes memory setup - 想控制上下文佔用的 token 量?設
contextTokens上限,超了會在詞邊界截斷 recallMode可以切換記憶呼叫方式:hybrid(注入+工具)、context(只注入)、tools(只用工具)
總結:外部記憶提供者 = 給 Agent 裝上一個「雲端大腦」。內建記憶是隨身筆記本,外部提供者是圖書館。選哪個?看你的場景——要跨 session 使用者建模,Honcho 很能打;要簡單持久化,其他幾個也各有千秋。先用 hermes memory setup 試試水,反正隨時可以 hermes memory off 關掉,不虧!
📖 官方文档
本文根据 Hermes Agent 官方文档编写,原文见:官方文档 › reference/cli-commands