🚀 Offizielle Hermes-Roadmap: Was kommt als Nächstes?
Offizielle Hermes-Roadmap: Nachrichtenreaktionen, OpenAI-kompatibler API-Server, Streaming-Unterstützung
🚀 Hermes Offizieller Fahrplan: Was kommt als Nächstes?
Hermes Agent veröffentlicht seine Entwicklungspläne offen im .plans-Verzeichnis auf GitHub, sodass du jederzeit unter die Haube schauen und genau sehen kannst, woran das Team als Nächstes arbeitet.
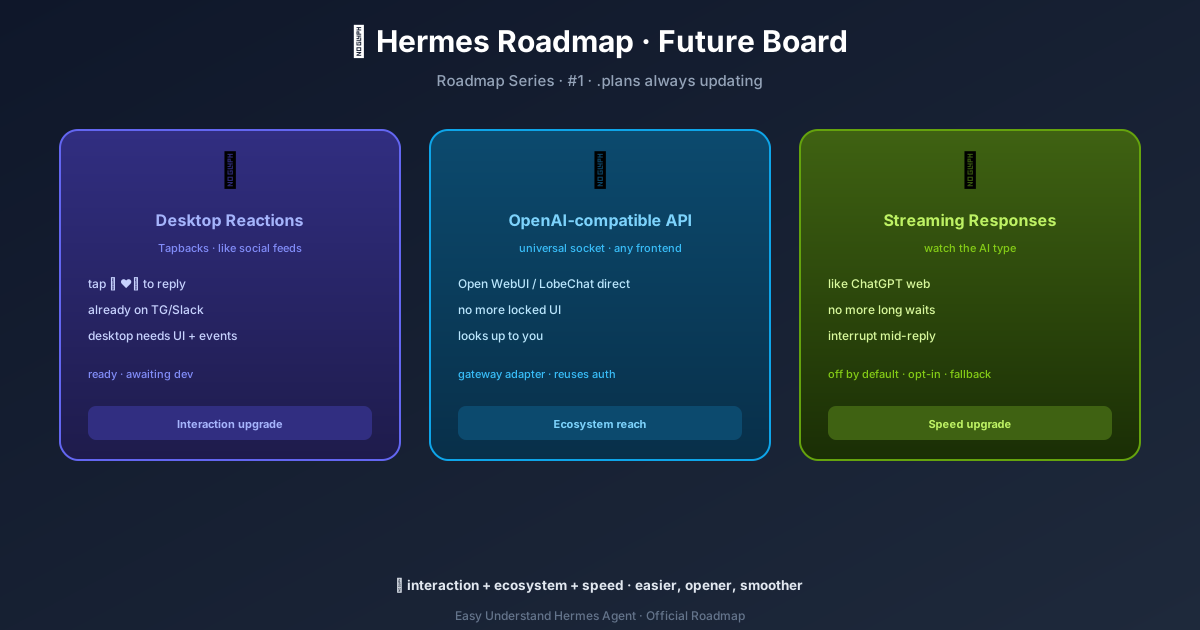
💬 Nachrichten-Reaktionen: Tapbacks auf dem Desktop
Was es ist: Denk an die „Doppeltippen zum Herzeln“-Funktion von Instagram oder iMessage. Du tippst auf eine Nachricht, und ein kleines Emoji (👍, ❤️, 😂, etc.) erscheint darauf. Hermes bringt genau dieses Erlebnis jetzt in sein Desktop-Transkript. Aktuell gibt es Reaktionen auf Plattformen wie Telegram, Slack und iMessage – aber die Desktop-App ist der Außenseiter. Dieser Plan schließt diese Lücke.
Nutzen für dich: Statt „ja“ oder „das ist lustig“ zu tippen, kannst du einfach auf eine Nachricht tippen und reagieren. Es ist schneller, ausdrucksstärker und fühlt sich natürlich an. Der Agent kann auch auf deine Nachrichten reagieren, sodass du ein schnelles, visuelles „Verstanden“ oder „👍“ bekommst, ohne eine vollständige Textantwort. Es ist eine kleine Änderung, die Gespräche viel menschlicher wirken lässt.
Aktueller Stand: Das Fundament steht solide. Das Agent-Tool (send_message(action="react")) existiert bereits, und die eingehende Konvention zum Lesen von Reaktionen ist plattformübergreifend etabliert. Nur die Desktop-Seite ist noch eine unbeschriebene Tafel – der Plan merkt explizit an, dass grep -ri reaction in der Desktop-App nur Haustier-Overlay-Herzen findet. Die Kerninfrastruktur ist also bereit; als Nächstes steht die UI-Arbeit an.
🌐 OpenAI-kompatibler API-Server
Was es ist: Stell dir deinen Hermes-Agenten als universelle Steckdose vor. Dieser Plan fügt eine Standardbuchse hinzu (eine OpenAI-kompatible REST-API), in die jedes Chat-Frontend eingesteckt werden kann. Statt an Hermes’ eigene Oberfläche gebunden zu sein, kannst du Open WebUI, LobeChat, LibreChat oder eines der Dutzende beliebter Chat-UIs verwenden, die die „OpenAI-Sprache“ sprechen.
Nutzen für dich: Wahlfreiheit und Vertrautheit. Wenn du das Aussehen und Gefühl von Open WebUI liebst, kannst du es auf dein Hermes-Backend richten und diese Oberfläche weiterhin nutzen. Du bekommst die Leistung von Hermes (Sitzungsverwaltung, Tool-Nutzung, Multi-Plattform-Unterstützung), verpackt in jedes Frontend, das du bereits kennst und liebst. Das macht Hermes außerdem sofort kompatibel mit einem riesigen Ökosystem bestehender Tools und Integrationen.
Aktueller Stand: Das befindet sich noch in der Designphase. Der Plan skizziert zwei Architektur-Optionen und empfiehlt klar Option A: den Aufbau als neuen Gateway-Plattform-Adapter. Dieser Ansatz nutzt die gesamte bestehende Gateway-Infrastruktur (Auth, Sitzungen, Kontextaufbau), was weniger zu wartenden Code und weniger Bugs bedeutet. Die Endpunkte sind definiert (/v1/chat/completions, /v1/models, /health), aber es wurde noch kein Code geschrieben.
⚡ Streaming von LLM-Antworten
Was es ist: Hast du schon einmal zugesehen, wie ChatGPT seine Antwort Wort für Wort tippt? Das ist Streaming. Dieser Plan bringt dieselbe Token-für-Token-Zustellung zu Hermes auf allen Plattformen – CLI, Telegram, Discord und dem zukünftigen API-Server. Statt zehn Sekunden auf einen „Denken…“-Spinner zu starren, siehst du die Antwort live entstehen.
Nutzen für dich: Gefühlte Geschwindigkeit und Feedback. Selbst wenn die Gesamtgenerierungszeit gleich ist, fühlt es sich dramatisch schneller an, Text erscheinen zu sehen. Du kannst außerdem früh erkennen, wohin der Agent steuert, und eingreifen, wenn er vom Kurs abkommt. Der Plan ist per Feature-Flag geschaltet (streaming.enabled: true in der Konfiguration), also opt-in – wenn du das aktuelle Verhalten bevorzugst, ändert sich für dich nichts.
Aktueller Stand: Die Architektur ist klar definiert: ein callback-basiertes System, bei dem der KI-Agent Text-Deltas in eine thread-sichere Warteschlange ausgibt, und jede Plattform (CLI, Gateway, API-Server) konsumiert diese Warteschlange auf ihre eigene Weise. Der Plan stellt explizit fest, dass der Agent-Kern plattformunabhängig ist, und eine elegante Degradierung ist eingebaut – wenn ein Anbieter kein Streaming unterstützt, fällt er stillschweigend auf den Nicht-Streaming-Pfad zurück. Das fühlt sich am nächsten an einer Implementierungsreife an.
🔮 Was das alles bedeutet
Diese drei Pläne zeichnen ein klares Bild: Hermes entwickelt sich von einem leistungsstarken, aber Nischen-Tool zu einer flexiblen, interoperablen Plattform. Nachrichten-Reaktionen machen Gespräche menschlicher. Die OpenAI-kompatible API macht Hermes zu einem Drop-in-Backend für das gesamte Chat-UI-Ökosystem. Streaming lässt jede Interaktion flott und reaktionsschnell wirken.
Zusammen senken sie die Einstiegshürde und heben die Decke dessen, was du tun kannst. Du wirst Hermes mit deinem Lieblings-Frontend nutzen können, seine Antworten in Echtzeit tippen sehen und mit einem einfachen Tipp auf Nachrichten reagieren können – alles ohne eine neue Oberfläche lernen zu müssen.
Der Fahrplan ist ein lebendiges Dokument. Das Team veröffentlicht diese Pläne öffentlich, und sie entwickeln sich basierend auf Community-Feedback und realer Nutzung weiter. Also schau regelmäßig vorbei – was heute „als Nächstes kommt“, könnte morgen schon in deinen Händen sein. Und wenn du Ideen hast: Das .plans-Verzeichnis ist aus einem bestimmten Grund öffentlich – deine Stimme kann mitbestimmen, was als Nächstes dort landet.
📖 Offizielle Dokumentation
この記事は Hermes Agent のOffizielle Dokumentationに基づいています:GitHub ›/tree/main/.plans