🚀 Hoja de Ruta Oficial de Hermes: ¿Qué Viene Después?
Hoja de ruta oficial de Hermes: reacciones a mensajes, servidor API compatible con OpenAI, soporte de streaming
Hermes Agent publica abiertamente sus planes de desarrollo en el directorio .plans de GitHub, para que siempre puedas echar un vistazo bajo el capó y ver exactamente qué está construyendo el equipo a continuación.
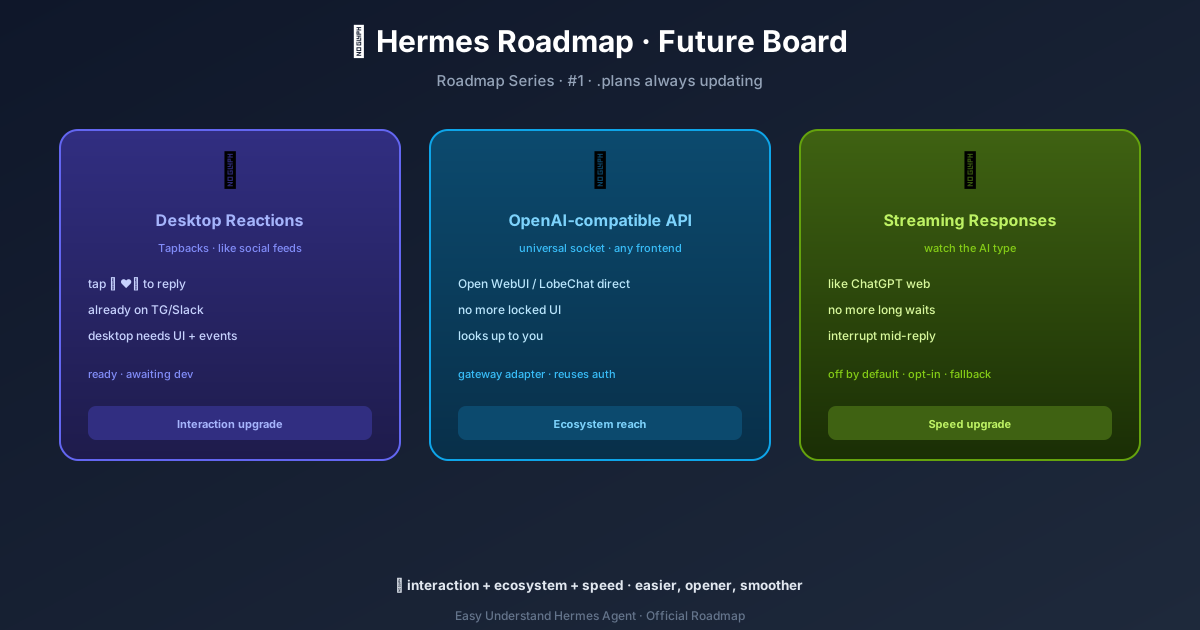
💬 Reacciones a Mensajes: Tapbacks en el Escritorio
Qué es: Piensa en la función de “doble toque para dar me gusta” de Instagram o iMessage. Tocas un mensaje y aparece un pequeño emoji (👍, ❤️, 😂, etc.) sobre él. Hermes está llevando esta misma experiencia a su transcripción de escritorio. Ahora mismo, las reacciones existen en plataformas como Telegram, Slack e iMessage, pero la aplicación de escritorio es la excepción. Este plan cierra esa brecha.
Beneficio para los usuarios: En lugar de escribir “sí” o “qué gracioso”, puedes simplemente tocar un mensaje y reaccionar. Es más rápido, más expresivo y se siente natural. El agente también puede reaccionar a tus mensajes, así que recibes un rápido y visual “entendido” o un “👍” sin necesidad de una respuesta de texto completa. Es un pequeño cambio que hace que las conversaciones se sientan mucho más humanas.
Progreso actual: Los cimientos son sólidos. La herramienta orientada al agente (send_message(action="react")) ya existe, y la convención entrante para leer reacciones está establecida en todas las plataformas. El lado del escritorio es la única pizarra en blanco: el plan señala explícitamente que grep -ri reaction en la aplicación de escritorio solo encuentra corazones de superposición de mascotas. Así que la tubería principal está lista; el trabajo de interfaz de usuario es lo siguiente.
🌐 Servidor API Compatible con OpenAI
Qué es: Imagina tu agente Hermes como un enchufe universal. Este plan añade un enchufe estándar (una API REST compatible con OpenAI) al que cualquier interfaz de chat pueda conectarse. En lugar de estar limitado a la interfaz propia de Hermes, puedes usar Open WebUI, LobeChat, LibreChat o cualquiera de las docenas de interfaces de chat populares que hablan el “idioma de OpenAI”.
Beneficio para los usuarios: Elección y familiaridad. Si te encanta el aspecto y la sensación de Open WebUI, puedes apuntarlo a tu backend de Hermes y seguir usando esa interfaz. Obtienes el poder de Hermes (gestión de sesiones, uso de herramientas, soporte multiplataforma) envuelto en cualquier interfaz que ya conozcas y ames. También hace que Hermes sea instantáneamente compatible con un ecosistema masivo de herramientas e integraciones existentes.
Progreso actual: Esto todavía está en la fase de diseño. El plan presenta dos opciones de arquitectura y recomienda claramente la Opción A: construirlo como un nuevo adaptador de plataforma de puerta de enlace. Este enfoque reutiliza toda la infraestructura de puerta de enlace existente (autenticación, sesiones, construcción de contexto), lo que significa menos código que mantener y menos errores. Los endpoints están definidos (/v1/chat/completions, /v1/models, /health), pero aún no se ha escrito ningún código.
⚡ Respuestas LLM en Streaming
Qué es: ¿Alguna vez has visto a ChatGPT escribir su respuesta palabra por palabra? Eso es streaming. Este plan añade la misma entrega token por token a Hermes en todas las plataformas: CLI, Telegram, Discord y el futuro servidor API. En lugar de mirar un spinner de “pensando…” durante diez segundos, ves la respuesta materializarse en vivo.
Beneficio para los usuarios: Velocidad percibida y retroalimentación. Incluso si el tiempo total de generación es el mismo, ver aparecer el texto se siente dramáticamente más rápido. También te permite captar la dirección del agente temprano e interrumpir si se está yendo por las ramas. El plan está marcado con una característica (streaming.enabled: true en la configuración), por lo que es opcional: si prefieres el comportamiento actual, nada cambia para ti.
Progreso actual: La arquitectura está bien definida: un sistema basado en callbacks donde el agente de IA emite deltas de texto en una cola segura para subprocesos, y cada plataforma (CLI, puerta de enlace, servidor API) consume esa cola a su manera. El plan establece explícitamente que el núcleo del agente es agnóstico a la plataforma, y la degradación elegante está integrada: si un proveedor no soporta streaming, cae silenciosamente al camino sin streaming. Este se siente como el más cercano a estar listo para implementarse.
🔮 Qué Significa Todo Esto
Estos tres planes pintan una imagen clara: Hermes está madurando de una herramienta poderosa pero de nicho a una plataforma flexible e interoperable. Las reacciones a mensajes hacen que las conversaciones sean más humanas. La API compatible con OpenAI convierte a Hermes en un backend de conexión directa para todo el ecosistema de interfaces de chat. El streaming hace que cada interacción se sienta ágil y receptiva.
Juntos, bajan la barrera de entrada y elevan el techo de lo que puedes hacer. Podrás usar Hermes con tu interfaz favorita, ver sus respuestas escribirse en tiempo real y reaccionar a los mensajes con un simple toque, todo sin aprender una nueva interfaz.
La hoja de ruta es un documento vivo. El equipo publica estos planes públicamente, y evolucionan según los comentarios de la comunidad y el uso en el mundo real. Así que vuelve a menudo: lo que “viene después” hoy podría estar ya en tus manos mañana. Y si tienes ideas, el directorio .plans es público por una razón: tu voz puede dar forma a lo que aparezca allí a continuación.
📖 Documentación oficial
Este artículo se basa en la documentación oficial de Hermes Agent :GitHub ›/tree/main/.plans