Tutoriel 25 : Exécution de code
Tutoriel 25 : Exécution de code — guide facile à comprendre basé sur la documentation officielle
Ce tutoriel fait partie de la série officielle de tutoriels Hermes Agent. Voir tous les tutoriels
Imaginez que vous prépariez un gâteau et qu’au lieu de récupérer les ingrédients un par un, vous écriviez la recette complète, la remettiez à un assistant, et qu’il ne vous rapporte que le gâteau fini. C’est exactement ce que fait l’exécution de code pour Hermes Agent : elle permet à l’agent d’exécuter un script Python complet qui appelle plusieurs outils à l’intérieur, puis ne renvoie que le résultat final à la conversation.
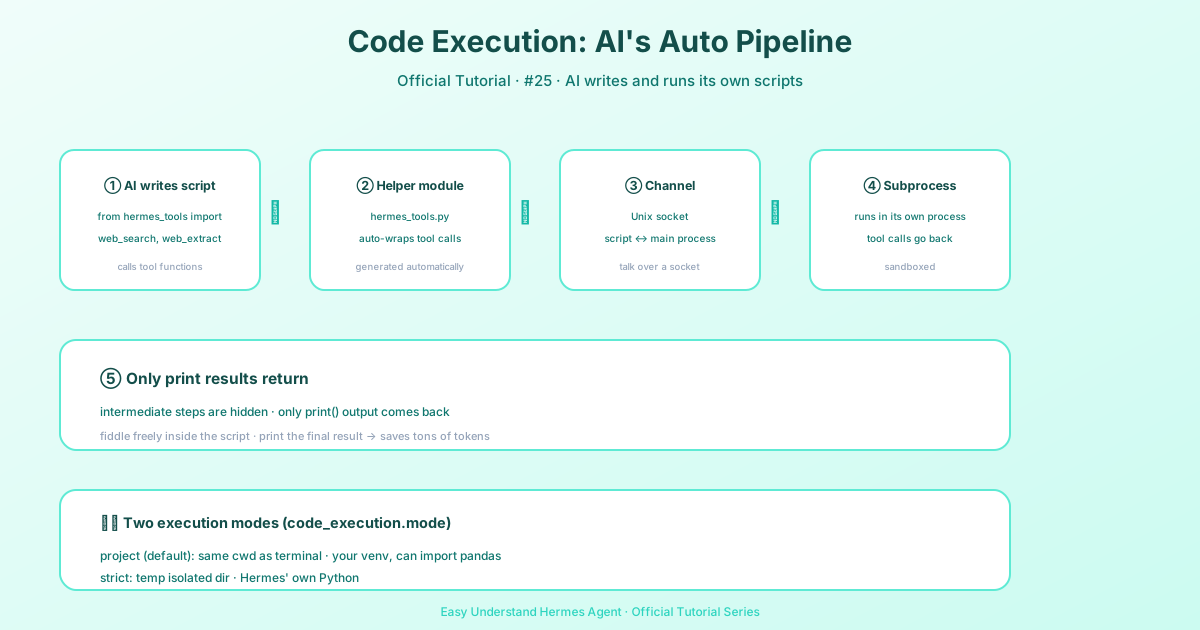
Qu’est-ce que l’exécution de code ?
Normalement, lorsqu’Hermes doit rechercher sur le web, lire un fichier ou exécuter une commande, il effectue chaque étape une par une — et chaque résultat intermédiaire est chargé dans sa “mémoire” (la fenêtre de contexte). C’est lent et ça gaspille des tokens.
Avec l’outil execute_code, Hermes écrit un script Python qui peut appeler des outils par programmation — comme web_search, read_file ou patch — en une seule fois. Le script s’exécute dans un processus enfant séparé, et seul le résultat de print() revient à l’agent. Toutes les données intermédiaires encombrantes restent cachées.
Comment ça fonctionne : étape par étape
Étape 1 : L’agent écrit un script Python
Il commence par importer les outils d’un module spécial :
from hermes_tools import web_search, web_extractÉtape 2 : Hermes crée un module d’assistance
Il génère automatiquement un fichier hermes_tools.py qui connecte votre script à l’agent principal.
Étape 3 : Un canal de communication s’ouvre
Hermes ouvre un socket Unix (une “ligne téléphonique” locale et rapide entre les processus) et démarre un thread d’écoute.
Étape 4 : Le script s’exécute dans un processus enfant
Chaque appel d’outil dans votre script transite par ce socket jusqu’à Hermes, qui l’exécute et renvoie le résultat.
Étape 5 : Seul le résultat de print() est renvoyé
Les instructions print() du script sont la seule chose que le LLM voit. Tous les résultats intermédiaires des outils n’entrent jamais dans la fenêtre de contexte — ce qui permet d’économiser énormément de tokens.
Quand Hermes utilise-t-il cette fonctionnalité ?
L’agent choisit automatiquement execute_code lorsqu’il détecte :
- 3 appels d’outils ou plus avec une logique entre eux (comme un filtrage ou une comparaison)
- Un traitement de données en masse — par exemple, rechercher dans de nombreux fichiers et extraire des extraits
- Des boucles — répéter une action sur de nombreux éléments
Le principal avantage ? L’efficacité des tokens. Au lieu de renvoyer chaque résultat de recherche dans la conversation, seul le résumé final est transmis.
Exemples pratiques à essayer
1. Pipeline de traitement de données
from hermes_tools import search_files, read_file
import json

# Trouver tous les fichiers de configuration et extraire les paramètres de base de données
matches = search_files("database", path=".", file_glob="*.yaml", limit=20)
configs = []
for match in matches.get("matches", []):
    content = read_file(match["path"])
    configs.append({"file": match["path"], "preview": content["content"][:200]})

print(json.dumps(configs, indent=2))
2. Recherche web en plusieurs étapes
from hermes_tools import web_search, web_extract
import json

results = web_search("Rust async runtime comparison 2025", limit=5)
summaries = []
for r in results["data"]["web"]:
    page = web_extract([r["url"]])
    for p in page.get("results", []):
        if p.get("content"):
            summaries.append({
                "title": r["title"],
                "url": r["url"],
                "excerpt": p["content"][:500]
            })

print(json.dumps(summaries, indent=2))
3. Refactorisation de fichiers en masse
from hermes_tools import search_files, read_file, patch

matches = search_files("old_api_call", path="src/", file_glob="*.py")
fixed = 0
for match in matches.get("matches", []):
    result = patch(
        path=match["path"],
        old_string="old_api_call(",
        new_string="new_api_call(",
        replace_all=True
    )
    if "error" not in str(result):
        fixed += 1

print(f"Fixed {fixed} files out of {len(matches.get('matches', []))} matches")
4. Pipeline de compilation et de test
from hermes_tools import terminal
import json

result = terminal("cd /project && python -m pytest --tb=short -q 2>&1", timeout=120)
output = result.get("output", "")

passed = output.count(" passed")
failed = output.count(" failed")

print(json.dumps({"passed": passed, "failed": failed}, indent=2))
Points clés à retenir
- Outils disponibles dans les scripts :
web_search,web_extract,read_file,write_file,search_files,patchetterminal(uniquement au premier plan). - Seul le résultat de
print()est renvoyé — tout le reste reste caché. - Idéal pour les boucles, le filtrage et les flux de travail en plusieurs étapes — c’est comme offrir à Hermes un mini-environnement de programmation.
Résumé
L’exécution de code transforme Hermes d’un assistant pas à pas en un processeur par lots. Il écrit un script, l’exécute et ne vous donne que la réponse finale — ce qui permet d’économiser du temps, des tokens et de la charge mentale. Si vous voyez Hermes effectuer beaucoup d’appels d’outils répétitifs, il utilise probablement cette fonctionnalité en arrière-plan.
À suivre : Tutoriel 26 — Traitement par lots : exécuter des centaines de requêtes en parallèle.
📖 Documentation officielle
Cet article est basé sur la documentation officielle de Hermes Agent :Docs officiels › user-guide/features/code-execution