Hermes 官方教學 · 第25篇2026/8/9· Easy Understand Hermes Agent
第25篇:程式碼執行——AI 寫程式碼跑程式碼
Hermes Agent 官方教學第25篇:AI 寫程式碼跑程式碼
第25篇:程式碼執行——AI 寫程式碼跑程式碼
你有沒有遇到過這種情況:讓 AI 幫你查資料、改檔案、跑指令,它得一步一步來,來回折騰好幾輪,既慢又費 token。今天要講的 execute_code 功能,就像給 AI 配了一個「自動流水線」——它自己寫腳本、自己呼叫工具、自己處理中間結果,最後只把成品端給你。
它是怎麼運作的?
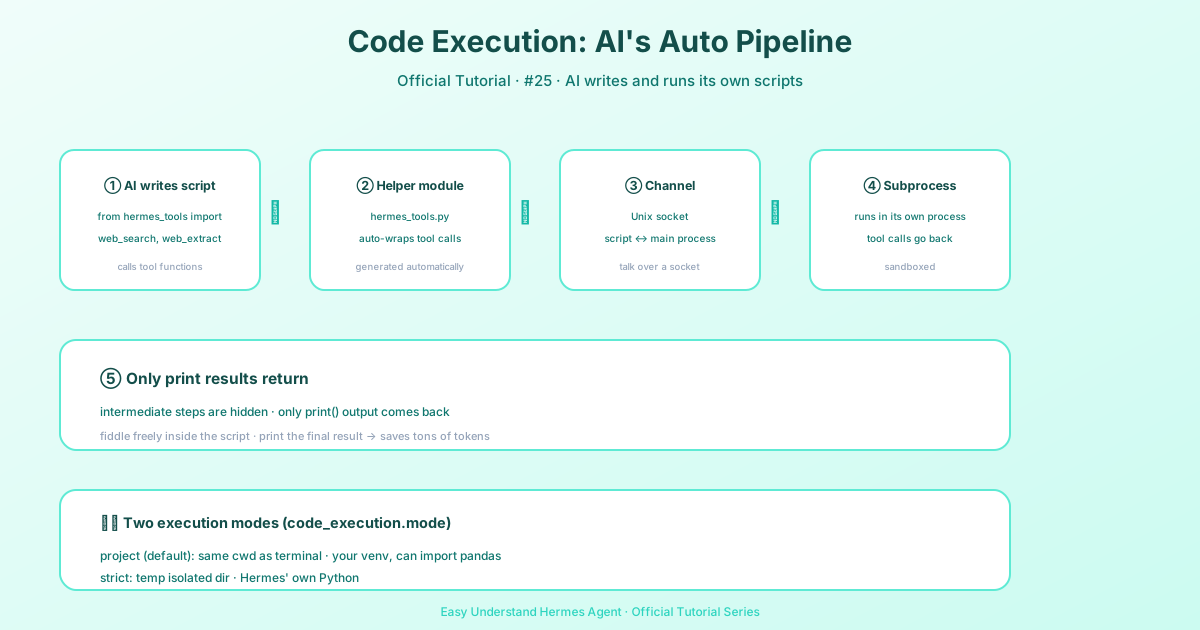
簡單說,就是讓 AI 寫一段 Python 腳本,腳本裡可以呼叫 Hermes 的各種工具(搜尋、讀檔、改程式碼、跑指令等)。整個流程分五步:
- AI 寫腳本:用
from hermes_tools import ...匯入工具函式 - Hermes 產生輔助模組:自動建立
hermes_tools.py,裡面封裝了工具呼叫介面 - 建立通訊通道:Hermes 開一個 Unix socket,讓腳本和主程式對話
- 子程序執行:腳本在獨立程序中執行,工具呼叫透過 socket 傳回 Hermes
- 只回傳 print 結果:腳本裡
print()的內容才會回到對話中,中間過程全部「屏蔽」
from hermes_tools import web_search, web_extract

results = web_search("Python 3.13 features", limit=5)
for r in results["data"]["web"]:
    content = web_extract([r["url"]])
    # 中間結果不會進入上下文視窗
print("搜尋完成,共處理", len(results["data"]["web"]), "條結果")
什麼時候 AI 會主動用這個功能?
- 需要連續呼叫 3 次以上工具,且中間有邏輯判斷
- 要批次篩選資料,比如從一堆檔案裡提取關鍵資訊
- 需要迴圈處理結果,比如逐個檢查並修復程式碼
最大的好處是:中間結果不進上下文視窗,只有最終的 print() 輸出回來,能省下大量 token。
實戰例子:批次改程式碼
假設要找出專案裡所有用了舊 API 的檔案並自動修復:
from hermes_tools import search_files, patch

matches = search_files("old_api_call", path="src/", file_glob="*.py")
fixed = 0
for match in matches.get("matches", []):
    result = patch(
        path=match["path"],
        old_string="old_api_call(",
        new_string="new_api_call(",
        replace_all=True
    )
    if "error" not in str(result):
        fixed += 1

print(f"已修復 {fixed} 個檔案,共找到 {len(matches.get('matches', []))} 處匹配")
兩種執行模式
在 ~/.hermes/config.yaml 裡可以設定 code_execution.mode:
| 模式 | 工作目錄 | Python 直譯器 |
|---|---|---|
| project(預設) | 和 terminal() 一致 |
優先使用你目前虛擬環境 |
| strict | 臨時隔離目錄 | 用 Hermes 自己的 Python |
建議:日常開發保持 project 模式,這樣腳本裡能正常 import pandas、存取專案檔案。只有在需要嚴格隔離時才切到 strict。
小結
execute_code 讓 AI 從「一步一步指揮」變成「寫個腳本全自動跑」,特別適合資料處理、批次重構、自動化測試這類場景。記住核心思路:腳本內部隨便折騰,只把最終結果 print 出來。
下一篇預告:第26篇將介紹 Hermes 的「檔案編輯」功能——AI 如何精準修改程式碼而不破壞其他內容,敬請期待!
📖 官方文档
本文根据 Hermes Agent 官方文档编写,原文见:官方文档 › user-guide/features/code-execution