Provider Routing — Smistamento Intelligente dei Modelli
Provider Routing — Smart Model Dispatching — easy-to-understand guide based on official docs
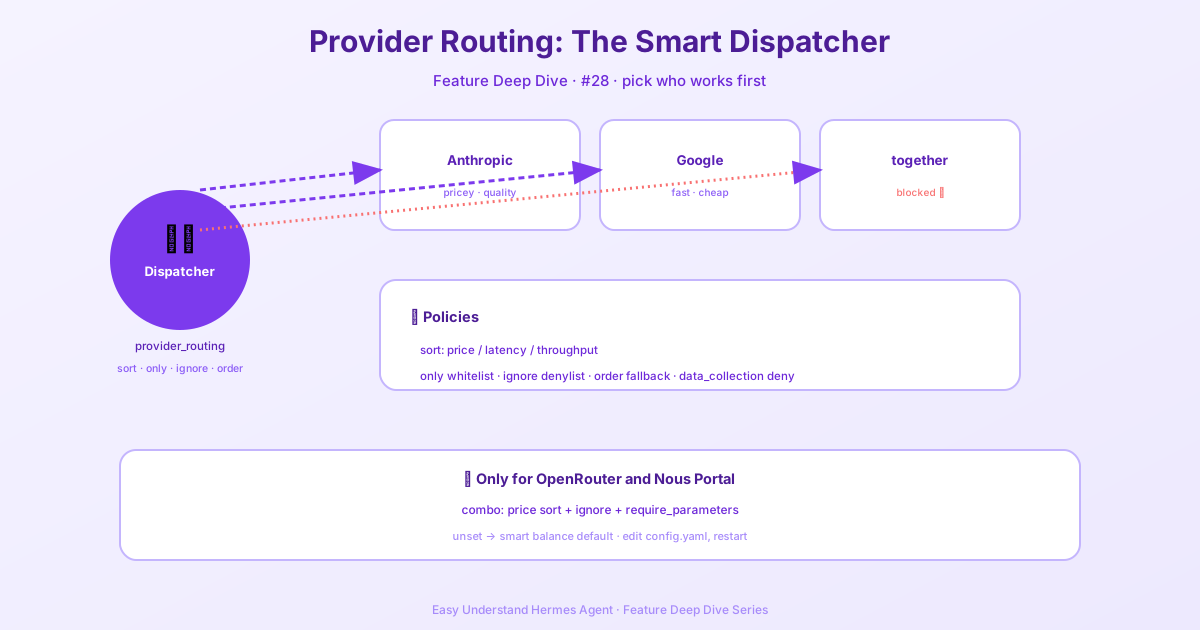
Provider Routing — Smistamento Intelligente dei Modelli
Se hai mai avuto la sensazione che il tuo agente AI stia usando una mazza per spaccare una noce, non sei solo. La maggior parte degli agenti esegue tutto tramite un unico modello grande e potente — anche i piccoli compiti secondari che non richiedono tutto quel cervello. Hermes cambia le cose con un sistema intelligente a due livelli: un modello principale per il pensiero, e modelli ausiliari per le cose di poco conto.
Pensalo come una cucina di ristorante. Hai lo chef executive (il modello principale) che gestisce ogni ordine, e poi hai le postazioni specializzate — un pasticciere, un cuoco alla griglia, un aiuto cuoco — ognuno che gestisce il proprio compito. È esattamente così che funziona Hermes.
Due Tipi di Slot per i Modelli
Hermes utilizza due tipi di slot per i modelli:
- Modello principale — il cervello. Ogni messaggio utente, ogni ciclo di chiamate agli strumenti, ogni risposta in streaming passa attraverso questo modello.
- Modelli ausiliari — i gregari. Questi gestiscono la compressione del contesto, la visione (analisi delle immagini), il riassunto delle pagine web, il punteggio di approvazione, il routing degli strumenti MCP, la generazione dei titoli delle sessioni e la ricerca delle competenze. Ognuno ha il proprio slot e può essere sovrascritto in modo indipendente.
La parte migliore? Puoi configurare tutto questo direttamente dalla dashboard.
La Pagina dei Modelli
Apri la dashboard e clicca su Models nella barra laterale. Vedrai due sezioni:
- Model Settings — il pannello superiore dove assegni i modelli agli slot.
- Usage analytics — schede classificate che mostrano ogni modello che ha eseguito una sessione, con conteggi di token, costi e badge delle capacità.
La scheda in alto è il pannello Model Settings. La riga principale mostra sempre cosa l’agente avvierà per le nuove sessioni. Clicca su Change per aprire il selettore.
Impostazione del Modello Principale
Il selettore ha due colonne:
- Sinistra — provider autenticati. Solo i provider che hai configurato (chiave API impostata, OAuth, o definiti come endpoint personalizzato) appaiono qui. Se un provider manca, vai su Keys e aggiungi le sue credenziali.
- Destra — l’elenco curato dei modelli per il provider selezionato. Questi sono i modelli agentici che Hermes raccomanda, non il dump grezzo di
/models(che su OpenRouter include 400+ modelli, inclusi TTS, generatori di immagini e reranker).
Digita nella casella di filtro per restringere la ricerca per nome del provider, slug o ID del modello.
Scegli un modello, premi Switch, e Hermes lo scrive in ~/.hermes/config.yaml nella sezione model. Questo vale solo per le nuove sessioni — qualsiasi scheda chat già aperta continua a usare il modello con cui è stata avviata. Per cambiare al volo la chat corrente, usa il comando slash /model al suo interno.
Cambi a Metà Sessione e Avvisi sul Contesto
Quando cambi modello all’interno di una sessione attiva, Hermes stima se il tuo prossimo messaggio attiverà la compressione del contesto preflight rispetto alla finestra del nuovo modello. Se la sessione è già vicina o supera la soglia di compressione di quel modello, la risposta al cambio include un avviso. Il cambio viene comunque applicato immediatamente; la compressione viene eseguita sul primo messaggio utente dopo il cambio.
Importante: I cambi a metà sessione azzerano la cache del prompt. Le cache dei prompt sono legate al modello che serve la richiesta, quindi qualsiasi cambio di modello a metà conversazione significa che il messaggio successivo rilegge l’intera conversazione al prezzo pieno dei token di input invece che alla tariffa cache (scontata del ~75–90%). In una sessione lunga, questa rilettura una tantum può superare la differenza per-token tra i due modelli. Cambia quando serve, ma preferisci farlo all’inizio di una conversazione.
Livelli di Addestramento Dati Non Presidiati
Alcuni modelli sono scontati perché il fornitore potrebbe addestrarsi sui tuoi prompt e completamenti. La selezione interattiva dei modelli mostra sempre un prompt di conferma. Ma i percorsi di avvio non interattivi come i worker Kanban e gli agenti cron falliscono in modalità sicura perché non possono porre quella domanda.
Se l’addestramento sui dati del carico di lavoro non presidiato è accettabile, registra un riconoscimento persistente:
hermes config set security.allow_data_training_tiers_noninteractive trueHermes stampa comunque l’avviso completo sulla politica dei dati e la chiave di riconoscimento a ogni avvio non presidiato, così i log dei worker mantengono una traccia di audit. Revoca con hermes config unset security.allow_data_training_tiers_noninteractive.
Impostazione dei Modelli Ausiliari
Clicca su Show auxiliary per rivelare gli 11 slot delle attività. Ogni attività ausiliaria è impostata su auto di default — il che significa che Hermes prova il tuo modello principale anche per quel compito. Se quel percorso non è disponibile o incontra un errore di capacità, auto segue qualsiasi catena di fallback specifica dell’attività, poi la catena di fallback principale, poi la catena di scoperta ausiliaria integrata di Hermes.
Sovrascrivi un’attività specifica quando vuoi un modello più economico o veloce per un compito secondario. Per esempio, potresti volere un modello minuscolo per la generazione dei titoli delle sessioni ma mantenere il tuo modello grande per le attività di visione.
Percorso Più Veloce: Nous Portal
Nous Portal offre 300+ modelli con un unico abbonamento. Su una nuova installazione, esegui hermes setup --portal per accedere e impostare Nous come tuo provider con un solo comando. Ispeziona cosa è configurato con hermes portal info. Gli abbonati al Portal ricevono anche 10% di sconto sui provider a pagamento a token.
Una Nota sullo Schema model:
Su un’installazione nuova di zecca, la configurazione predefinita inclusa ha model: "" (un sentinella stringa vuota che significa “non ancora configurato”). La prima volta che esegui hermes setup o hermes model, quella chiave viene aggiornata in-place in una mappatura con le sotto-chiavi provider, default, base_url e api_mode. Se mai vedi una stringa vuota in config.yaml, esegui hermes model (o clicca Change nella dashboard) e Hermes scriverà la forma dizionario per te.
Lo smistamento intelligente dei modelli significa che non paghi prezzi da modello di punta per il lavoro di routine. Il tuo modello principale gestisce il pensiero pesante, mentre modelli più piccoli ed economici gestiscono i compiti di routine. È efficiente, conveniente e ti dà un controllo granulare su ogni parte del flusso di lavoro del tuo agente.
📖 Documentazione ufficiale
この記事は Hermes Agent のDocumentazione ufficialeに基づいています:Documentazione ufficiale › user-guide/configuring-models