プロバイダールーティング — スマートなモデル振り分け
Provider Routing — Smart Model Dispatching — easy-to-understand guide based on official docs
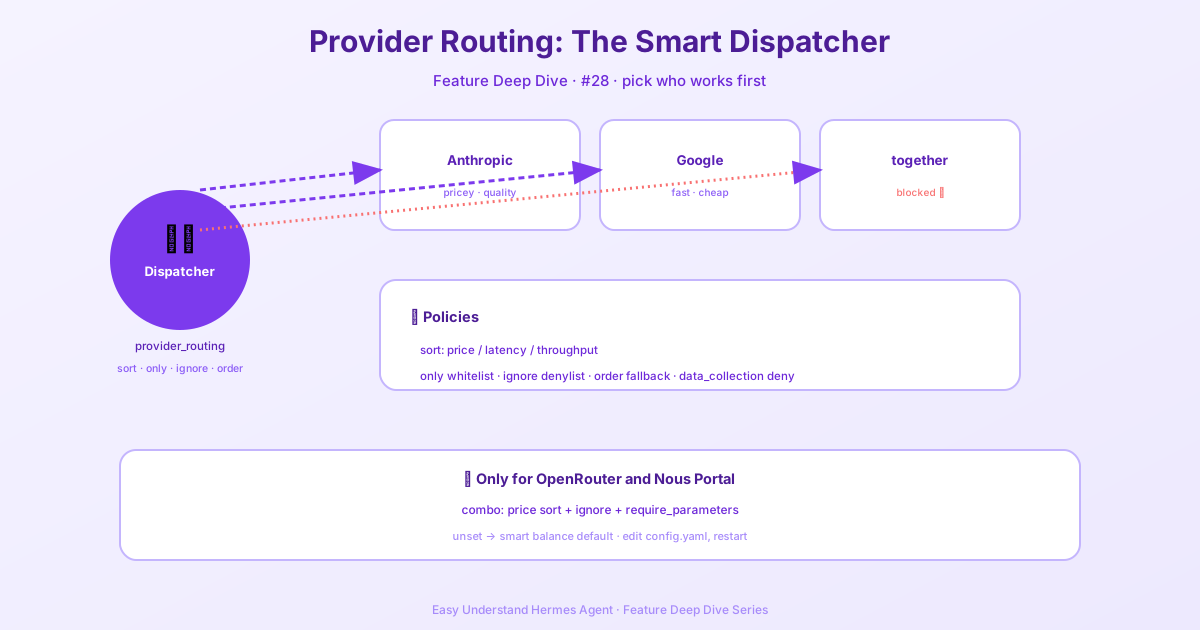
プロバイダールーティング — スマートなモデル振り分け
「AIエージェントが釘を打つためにハンマーを使っている」と感じたことはありませんか? 実はそれ、あなただけじゃないんです。ほとんどのエージェントは、そんなに頭を使わなくていい小さな作業まで、すべてひとつの大きな高性能モデルに通しています。Hermesは、メインモデル(思考担当)と補助モデル(細かい作業担当)というスマートな2層構造で、この問題を解決します。
レストランの厨房を想像してみてください。すべての注文を処理する料理長(メインモデル)がいて、その下にパティシエ、グリル担当、下ごしらえ担当といった専門のセクションがあります。それぞれが自分のタスクを担当する——まさにHermesの仕組みはこれと同じです。
2種類のモデルスロット
Hermesには、2種類のモデルスロットがあります:
- メインモデル — 頭脳です。すべてのユーザーメッセージ、ツール呼び出しループ、ストリーミング応答は、すべてこのモデルを経由します。
- 補助モデル — サポート役です。コンテキスト圧縮、ビジョン(画像分析)、Webページ要約、承認スコアリング、MCPツールルーティング、セッションタイトル生成、スキル検索を担当します。それぞれに専用スロットがあり、個別に上書き設定が可能です。
さらに嬉しいことに、これらはすべてダッシュボードから設定できます。
モデルページ
ダッシュボードを開いて、サイドバーのModelsをクリックします。2つのセクションが表示されます:
- Model Settings — 上部パネルで、各スロットにモデルを割り当てます。
- Usage analytics — セッションを実行した各モデルを、トークン数・コスト・機能バッジ付きのランキングカードで表示します。
一番上のカードがModel Settingsパネルです。メインの行には、新しいセッションでエージェントが起動するモデルが常に表示されています。Changeをクリックするとピッカーが開きます。
メインモデルの設定
ピッカーには2つのカラムがあります:
- 左側 — 認証済みプロバイダー。APIキーを設定済み、OAuth認証済み、またはカスタムエンドポイントとして定義済みのプロバイダーのみがここに表示されます。プロバイダーが見つからない場合は、Keysに移動して認証情報を追加してください。
- 右側 — 選択したプロバイダーで利用可能な厳選モデルリスト。Hermesが推奨するエージェント向けモデルであり、生の
/models一覧(OpenRouterではTTS、画像生成、リランカーを含む400以上のモデルがあります)ではありません。
フィルターボックスに入力すると、プロバイダー名・スラッグ・モデルIDで絞り込めます。
モデルを選んでSwitchをクリックすると、Hermesが~/.hermes/config.yamlのmodelセクションに書き込みます。これは新しいセッションにのみ適用されます — すでに開いているチャットタブは、開始時のモデルを引き続き使用します。現在のチャットをホットスワップするには、チャット内で/modelスラッシュコマンドを使用してください。
セッション途中の切り替えとコンテキスト警告
アクティブなセッション内でモデルを切り替えると、Hermesは次のメッセージが新しいモデルのウィンドウに対してプリフライトコンテキスト圧縮を実行するかどうかを推定します。セッションがすでに新しいモデルの圧縮しきい値に近いか、それを超えている場合、切り替え応答に警告が含まれます。切り替えは即座に適用されます。圧縮は切り替え後の最初のユーザーメッセージで実行されます。
重要: セッション途中の切り替えはプロンプトキャッシュをリセットします。プロンプトキャッシュはリクエストを処理するモデルに紐づいているため、会話の途中でモデルを変更すると、次のメッセージはキャッシュされた割引料金(約75〜90%オフ)ではなく、全入力トークン料金で会話全体を再読込することになります。長いセッションの場合、この一度きりの再読込コストが、2つのモデルのトークン単価差をはるかに上回る可能性があります。切り替えが必要な場合は実行してください。ただし、会話の早い段階で行うことをお勧めします。
無人データトレーニング層
一部のモデルは、ベンダーがプロンプトと応答をトレーニングに使用する可能性があるため、割引料金になっています。インタラクティブなモデル選択では、常に確認プロンプトが表示されます。しかし、Kanbanワーカーやcronエージェントなどの非インタラクティブな起動パスでは、その質問ができないため、フェイルクローズ(安全側に倒して拒否)します。
無人ワークロードのデータに対するトレーニングを許容できる場合は、永続的な承認を記録します:
hermes config set security.allow_data_training_tiers_noninteractive trueHermesは、無人起動のたびに完全なデータポリシー警告と承認キーを表示し続けるため、ワーカーログに監査証跡が残ります。取り消すにはhermes config unset security.allow_data_training_tiers_noninteractiveを実行します。
補助モデルの設定
Show auxiliaryをクリックすると、11個のタスクスロットが表示されます。すべての補助タスクはデフォルトでautoに設定されています — つまり、Hermesはそのジョブにもメインモデルを使用しようとします。そのルートが利用できない場合や容量系の障害が発生した場合、autoはタスク固有のフォールバックチェーン、次にメインフォールバックチェーン、そしてHermes組み込みの補助モデル発見チェーンの順にフォールバックします。
サイドジョブに、より安価または高速なモデルを使いたい場合は、特定のタスクを上書きします。たとえば、セッションタイトル生成には小さなモデルを使い、ビジョンタスクには大きなモデルを維持する、といった設定が可能です。
最速パス:Nous Portal
Nous Portalは、1つのサブスクリプションで300以上のモデルを提供します。新規インストール時には、hermes setup --portalを実行してログインし、Nousをプロバイダーとして設定するまでを1コマンドで完了できます。配線状況の確認はhermes portal infoで行えます。Portalサブスクライバーは、トークン課金プロバイダーが10%オフになります。
model:スキーマについての注意
新規インストール時、バンドルされているデフォルト設定ではmodel: ""(「未設定」を意味する空文字列のセンチネル)になっています。初めてhermes setupまたはhermes modelを実行すると、そのキーはprovider、default、base_url、api_modeのサブキーを持つマッピングにその場でアップグレードされます。config.yamlに空文字列が表示された場合は、hermes modelを実行するか(またはダッシュボードでChangeをクリック)、Hermesが辞書形式を書き込んでくれます。
スマートなモデル振り分けにより、雑務にフラッグシップモデルの料金を払う必要がなくなります。メインモデルは高度な思考を担当し、小さくて安価なモデルが定型タスクを処理します。効率的でコスト効果が高く、エージェントのワークフローのすべての部分を細かく制御できます。
📖 公式ドキュメント
この記事は Hermes Agent の公式ドキュメントに基づいています:公式ドキュメント › user-guide/configuring-models