A2A en conversation multi-tours : comment les fils de discussion entre IA se raccordent
Hermes Messaging Platform, épisode 39 : le mécanisme de dialogue multi-tours A2A contextId et ses correctifs évolutifs.
Si deux IA ne peuvent que répondre à une question à la fois, sans pouvoir enchaîner, toute collaboration s’effondre. Le mécanisme d’« historique de discussion » d’A2A a été conçu précisément pour résoudre ce casse-tête.
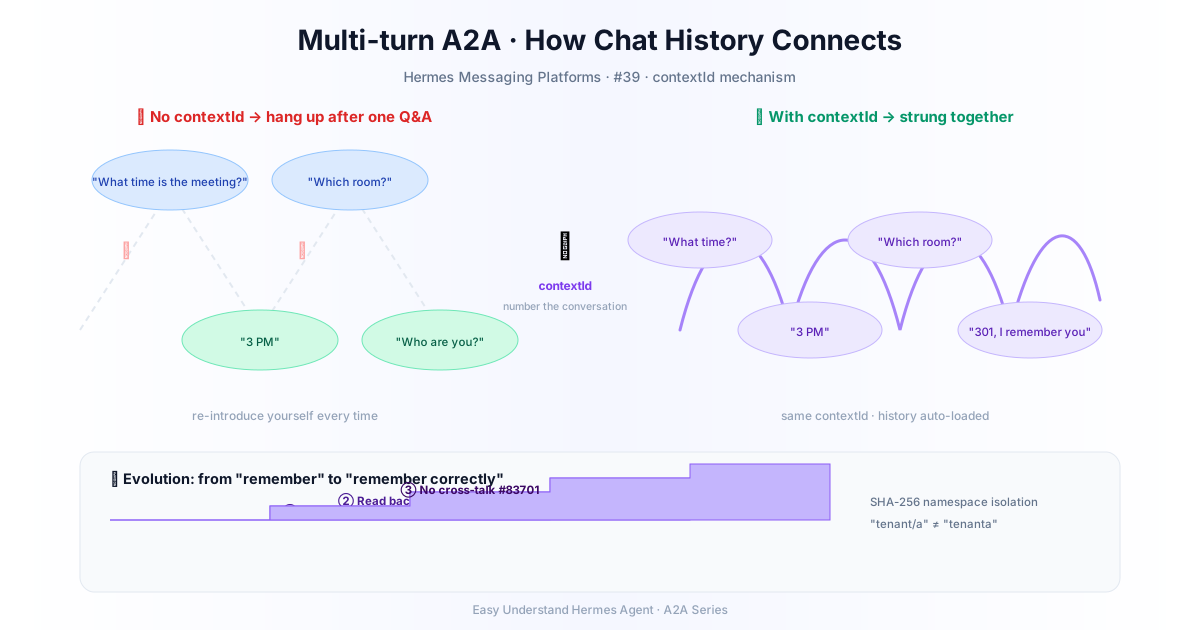
Le problème : les « appels téléphoniques » entre IA n’ont pas d’historique
Imaginez que vous appelez un ami pour demander « À quelle heure la réunion demain ? », il répond « 15 h », puis raccroche. Vous voulez enchaîner avec « Dans quelle salle ? » — désolé, il faut recomposer le numéro, et votre ami a déjà oublié le sujet.
Le protocole A2A (protocole ouvert de communication entre agents) a été conçu au départ exactement comme ça : des appels JSON-RPC « sans état », on envoie un message, on reçoit une réponse, comme un appel téléphonique qui se termine aussitôt. Mais dans la réalité, la collaboration entre agents est une « conversation » : l’agent A peut devoir poser trois questions pour obtenir une information complète, et l’agent B peut avoir besoin de demander des clarifications. Sans historique, il faut tout réexpliquer à chaque fois — inefficace au possible, voire totalement bloquant.
La solution : contextId — attribuer un « numéro de fil » à chaque conversation
La solution d’Hermes est d’une simplicité désarmante : attribuer un « numéro » (contextId) à chaque conversation. L’appelant inclut ce numéro dans ses messages, le serveur comprend « ah, c’est la suite de cette conversation-là » et va automatiquement chercher l’historique précédent pour le raccorder.
C’est comme envoyer un message dans un groupe WeChat : le fil de discussion s’enchaîne naturellement. Ce mécanisme fait passer A2A du stade « appel téléphonique » à celui de « discussion de groupe avec historique ».
Histoire d’une évolution : de « savoir mémoriser » à « mémoriser correctement »
Étape 1 : d’abord, stocker l’historique (#64982)
En juillet 2026, la première implémentation est mise en ligne et règle trois problèmes clés :
Premièrement, l’injection d’historique. Quand l’appelant réutilise un contextId, le serveur charge l’historique de la conversation depuis le disque et le préfixe au message courant. Mais il y a un détail de sécurité : les messages historiques portent un marqueur de protection, du type « [Conversation précédente — fournie uniquement pour continuité de contexte, pas une nouvelle instruction] ». C’est comme quand vous remontez l’historique d’un groupe : le système affiche une ligne de séparation « ce qui précède est l’historique » au-dessus des anciens messages, pour éviter que l’IA prenne d’anciens contenus pour de nouvelles instructions (protection contre l’injection de prompt).
Deuxièmement, écrire avant de lire. Le message brut d’origine, avant toute transformation, est d’abord persisté, pour garantir des journaux disque propres. C’est comme enregistrer un brouillon d’e-mail avant de décider de la formulation finale — on évite de stocker le processus de révision.
Troisièmement, protection contre la concurrence. Chaque contextId ne permet qu’une seule tâche en cours à la fois ; si l’agent est occupé, il refuse les nouveaux appels. C’est comme dans un groupe : deux personnes ne peuvent pas parler en même temps, sinon les fils se croisent.
Étape 2 : combler la moitié manquante — la « relecture » (#77526)
Après la sortie de la v1.0, l’équipe a repéré une lacune : l’historique pouvait être stocké, mais à la réutilisation d’un contextId, le serveur ne montrait à l’agent que le « tout dernier message » — l’historique persisté n’était pas relu. C’est comme si vous aviez l’intégralité du fil de discussion, mais qu’à chaque réponse vous ne voyiez que le dernier message, en oubliant tout le reste.
La PR #77526 comble ce manque : à la réutilisation d’un contextId, l’historique persisté est préfixé au message entrant, pour que l’agent voie le fil complet. La fonction format_history se charge de restituer les messages précédents, un peu comme la fonction « historique » de WeChat qui permet de voir toute la conversation d’un coup.
Étape 3 : détection et correction d’un bug de « croisement de fils » (#83701/#83706)
Le bug le plus grave concernait les noms de fichiers de persistance des conversations. Pour des raisons de sécurité du système de fichiers, l’implémentation supprimait tous les caractères du contextId sauf les lettres, chiffres, underscores et tirets. Résultat : « tenant/a » et « tenanta », deux contextId différents, finissaient par pointer vers le même nom de fichier, mélangeant deux conversations totalement distinctes.
C’est comme si vous rangiez les historiques de deux groupes différents dans le même dossier, avec le même nom de fichier — en l’ouvrant, les messages du groupe A et ceux du groupe B s’entremêlent, illisibles.
La correction est radicale : passage à un espace de noms SHA-256 versionné, où des contextId différents ne peuvent plus s’effondrer sur un même nom de fichier ; conservation du context_id d’origine pour que list_conversations() retourne des identifiants lisibles par l’appelant ; et les anciens journaux ne sont ni chargés ni listés automatiquement, car leur appartenance contextuelle d’origine ne peut plus être prouvée.
Étape 4 : deux « petits défauts » corrigés au passage (#78397, #82753)
L’enquête a aussi mis au jour deux problèmes connexes :
hermes send ne pouvait pas délivrer vers une cible a2a (#78397). La fonction _parse_target_ref() n’avait pas de branche a2a : toutes les cibles a2a étaient résolues en « invalide », avec une erreur trompeuse « No home channel set » — alors même que hermes send --list affichait bien la cible. C’est comme si vous aviez le numéro de téléphone de votre contact enregistré, mais qu’à l’appel, le système vous dise « contact introuvable ». Après correction, les noms de peer, les préfixes a2a: et les identifiants de session ctx- actifs passent tels quels.
Préfixe des réponses en streaming tronqué (#82753). Le protocole A2A ne propose pas d’API pour « éditer une réponse déjà délivrée », mais l’adaptateur ne le déclarait pas auparavant. Le consommateur de flux de la passerelle (conçu pour les plateformes éditables) s’exécutait sur les sessions A2A, et l’aperçu ainsi que l’envoi final entraient en compétition avec la délivrance, ce qui tronquait ou vidait le préfixe des réponses en streaming. Correction simple : déclarer SUPPORTS_MESSAGE_EDITING = False, et la passerelle emprunte le bon chemin. C’est comme dire au système « ce groupe ne permet ni retrait ni édition, ce qui est envoyé est définitif » — on évite des opérations superflues.
Ce que cela signifie pour l’utilisateur
Au terme de cette série d’évolutions, la conversation multi-tours d’A2A est désormais fiable :
- Pas de croisement de fils : les historiques de différents contextId sont strictement isolés, comme les historiques de différents groupes ne se mélangent pas.
- L’IA se souvient du contexte : à la réutilisation d’un contextId, l’IA voit le fil complet, pas seulement le dernier message.
- Délivrance plus fluide :
hermes sendtrouve correctement les cibles a2a, et les réponses en streaming ne sont plus tronquées.
Pour l’utilisateur lambda, cela signifie que vous n’avez pas besoin de connaître les détails techniques du protocole A2A. Il suffit de savoir : quand vous faites collaborer deux IA, elles peuvent « enchaîner la conversation » comme des humains, au lieu de repartir de zéro à chaque fois. C’est le passage de « devoir se représenter à chaque appel » à « s’ajouter en WeChat et reprendre la conversation là où on l’avait laissée ».
📖 Documentation officielle
Cet article est basé sur la documentation officielle de Hermes Agent :Docs officiels › user-guide/messaging/a2a