Le mystère des tâches A2A longues : pourquoi les travaux de plus de deux minutes échouaient toujours
Hermès Messagerie — Épisode 38 : Triple cause et correctif du problème de dépassement de délai des tâches longues A2A.
Deux Hermes sur deux machines différentes se « passent des coups de fil » pour se confier des tâches, et dès que la tâche dépasse deux minutes, c’est l’échec — peu importe comment on règle la configuration. Ce n’est pas de la magie noire, c’est trois petits pièges qui s’empilent.
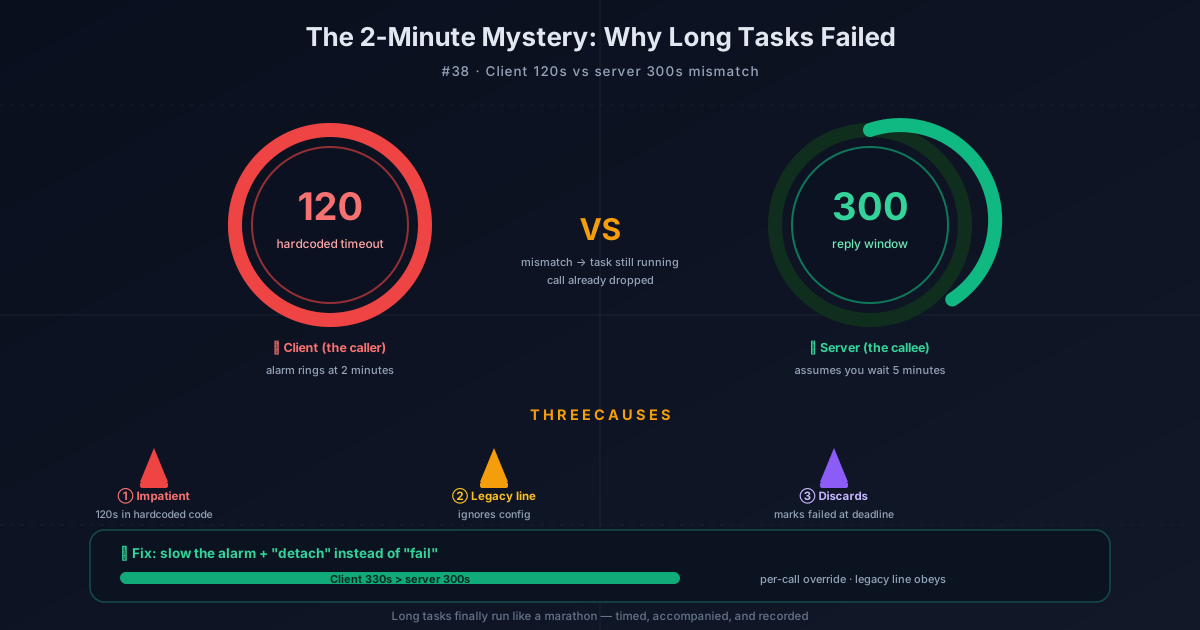
L’énigme : la malédiction des deux minutes
Imaginez que vous demandiez à un collègue A de traiter un dossier, en lui disant qu’il vous appellera pour vous donner le résultat une fois terminé. Résultat : dès que l’appel dépasse deux minutes, ça raccroche sec chez vous, et l’écran affiche « appel échoué ». Vous avez essayé de changer de téléphone, de ligne, même de bureau — le problème persiste.
C’est exactement ce qui arrive aux utilisateurs d’Hermes. Deux machines font chacune tourner un Hermes, connectées via le plugin A2A (protocole de communication ouvert entre agents). La machine A confie une tâche à la machine B, et dès que la tâche dépasse environ 2 minutes, c’est l’échec garanti. Dans la communauté, on appelle ça « la réponse longue qui casse le suivi de progression ». Le plus frustrant : côté B, le travail est en fait terminé, mais la machine A ne reçoit jamais le résultat.
Cause n°1 : celui qui appelle n’a pas de patience
Le premier piège, c’est purement un problème de « tempérament pressé ».
Le client Hermes a un délai d’expiration par défaut — 120 secondes. Concrètement ? Celui qui appelle s’est réglé une minuterie : si l’autre ne répond pas dans les 120 secondes, je raccroche. Mais côté serveur ? Il réserve une fenêtre de réponse de 300 secondes pour que l’agent fasse son travail, soit 5 minutes.
Vous voyez le décalage : celui qui appelle raccroche au bout de 2 minutes, alors que celui qui répond croit avoir 5 minutes de patience devant lui. Résultat : la tâche tourne encore, et la ligne est déjà coupée. Et ce 120 secondes est codé en dur dans le code — un utilisateur lambda ne trouve même pas où le modifier.
Cause n°2 : la vieille ligne n’a pas d’interrupteur de « délai »
Le deuxième piège, c’est un héritage historique.
Hermes propose deux façons d’appeler A2A : la « standard via standardiste » (appel via les pairs configurés), et la « vieille ligne directe » (appel direct avec l’URL brute). La vieille ligne date des premières versions, elle a aussi un délai de 120 secondes codé en dur, et elle ne lit pas les fichiers de configuration.
Autrement dit, même si vous apprenez à modifier le délai d’expiration, la vieille ligne n’en a rien à faire. C’est comme mettre des piles neuves dans un vieux téléphone fixe : il n’a tout simplement pas de molette de volume.
Cause n°3 : à l’heure dite, on jette le résultat
Le troisième piège est le plus vicieux : côté serveur, à l’heure dite, on « vide la salle ».
Disons que vous avez enfin réussi à augmenter le délai du client, et que vous avez survécu aux deux premiers pièges. Et là, le serveur vous sort une nouvelle surprise : dès que la fenêtre de réponse de 300 secondes expire, il marque la tâche comme « échouée », même si l’agent est encore en train de bosser dur. Pire : cet état « échoué » est collant — comme de la glue, impossible de s’en défaire. Quand l’agent a enfin terminé et revient avec le résultat, plus personne ne l’attend, et le résultat est purement et simplement jeté.
C’est comme un livreur qui s’arrête à l’heure pile, peu importe si votre colis est livré ou non : le système affiche d’abord « livraison échouée ». Le lendemain, quand vous recevez enfin le colis, le suivi reste bloqué sur « échec » pour toujours, impossible de corriger.
Étape 1 de l’enquête : ralentir la minuterie
Une fois les trois pièges identifiés, la réparation devient simple.
Premier correctif, évident : passer le délai d’expiration par défaut du client de 120 secondes à 330 secondes. 330 secondes > 300 secondes côté serveur : comme ça, celui qui appelle est plus patient que celui qui répond, et la tâche survit à la fenêtre de réponse du serveur. En parallèle, a2a_call gagne un paramètre de dépassement de délai par appel — vous pouvez régler le délai individuellement pour chaque tâche, sans toucher au réglage global. Et la vieille ligne a enfin été « modernisée » : elle lit désormais la configuration, et hérite de l’authentification et des réglages de délai.
Étape 2 de l’enquête : « détacher » la tâche au lieu de la « faire échouer »
Le deuxième correctif est plus malin. À l’expiration de la fenêtre, le serveur ne marque plus la tâche comme échouée, mais la « détache ». Concrètement ? C’est comme une file d’attente au service client : si vous en avez marre d’attendre, vous pouvez raccrocher, mais votre ticket reste dans le système, et vous recevrez un SMS une fois le traitement terminé.
En détail : quand la fenêtre de réponse expire, l’appelant reçoit un état non terminal « en cours », avec des instructions. La tâche reste à l’état WORKING, et le système programme un « observateur borné » pour continuer à surveiller. Quand l’agent a vraiment terminé, le vrai résultat est enregistré. Ensuite, que ce soit via tasks/get ou tasks/resubscribe, l’observateur peut voir le résultat final. Les résultats tardifs ne sont plus jetés.
Étape 3 de l’enquête : les pièges du voisinage réparés au passage
En réglant l’affaire principale, on a aussi déniché quelques pièges chez les voisins.
Réponses streaming tronquées : avant, les réponses streaming pouvaient ne renvoyer que le dernier segment à l’appelant. Par exemple, un long event_id tronqué pour ne garder que la deuxième partie — l’appelant recevait des infos incomplètes. Maintenant, la réponse cumulée est conservée intégralement, et les 152 cas de test passent tous.
Fausse complétion : quand le budget d’itérations de l’agent était épuisé, on renvoyait un résumé « terminé », mais le pair ne pouvait pas distinguer un « travail tronqué » d’un « travail réussi », et pouvait accepter un résultat partiel comme complet. Désormais, les tâches tronquées signalent explicitement TASK_STATE_FAILED, sans se faire passer pour un succès.
Lanceur externe : les utilisateurs non-root peuvent maintenant configurer un lanceur d’agents externe, exécuter des sous-processus ou des workers RPC versionnés, avec prise en charge de la sortie bornée, du nettoyage de l’arbre de processus, de l’annulation et de la terminaison exactement une fois. Trois vieux problèmes réglés : visibilité de la complétion, alignement des délais, et continuité multi-tours.
Ce que ça change pour vous
Désormais, quand deux Hermes se confient des tâches, les travaux de plus de deux minutes ne « ratent plus à coup sûr ». Le délai est réglable, et la vieille ligne obéit enfin. Surtout : même si le serveur n’en peut plus d’attendre, la tâche n’est plus « condamnée » — elle reste en cours, le résultat est enregistré normalement une fois le travail fini, et vous pouvez le consulter à tout moment.
Les tâches longues sont enfin comme un marathon : quelqu’un chronomètre, quelqu’un court à vos côtés, quelqu’un enregistre le résultat. Fini l’époque où l’arbitre sifflait à mi-parcours et annulait la performance.
📖 Documentation officielle
Cet article est basé sur la documentation officielle de Hermes Agent :Docs officiels › user-guide/messaging/a2a