O Mistério das Tarefas Longas no A2A: Por Que Trabalhos Acima de Dois Minutos Sempre Falham
Plataforma de mensagens Hermes, artigo 38: as três causas e a correção do problema de timeout em tarefas longas A2A.
Dois Hermes em máquinas diferentes “ligam” um para o outro para delegar tarefas, e tudo que passa de dois minutos falha — não importa quantas configurações você ajuste. Isso não é misticismo, são três pegadinhas empilhadas.
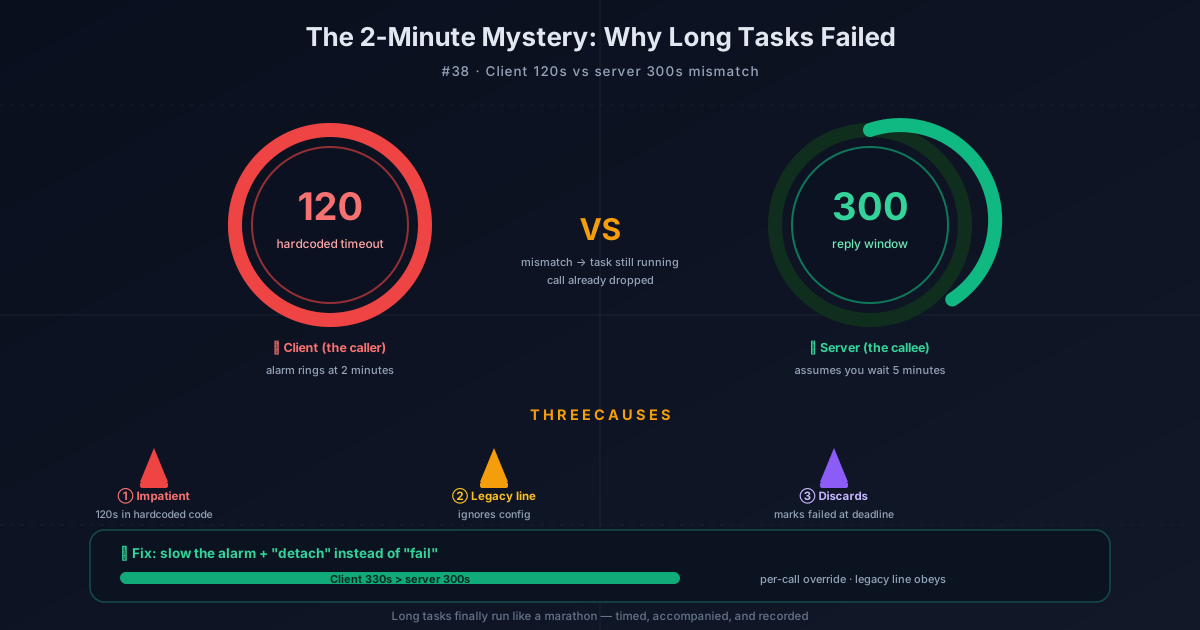
O Enigma: A Maldição dos Dois Minutos
Imagine que você pede para o colega A processar um arquivo, combinando que ele te liga quando terminar. Só que toda chamada que passa de dois minutos, do seu lado “tchau” — a ligação cai e aparece “falha na chamada”. Você tenta trocar de telefone, trocar de linha, até mudar de escritório, e o problema persiste.
É exatamente isso que os usuários do Hermes enfrentam. Duas máquinas, cada uma rodando um Hermes, conectadas pelo plugin A2A (protocolo aberto de comunicação entre agentes). A máquina A delega a tarefa para a B, e sempre que a tarefa demora mais de ~2 minutos, falha na certa. A comunidade chama isso de “long reply quebrando o rastreamento de progresso”. O mais irritante: do lado da máquina B, o trabalho até foi concluído, mas a máquina A nunca recebe o resultado.
Causa 1: Quem Liga Não Tem Paciência
A primeira pegadinha é puramente questão de “ansiedade”.
O cliente Hermes tem uma configuração de timeout padrão — 120 segundos. O que isso significa? Quem liga colocou um despertador para si mesmo: se a outra parte não responder em 120 segundos, eu desligo. Mas e o servidor? Ele reserva uma janela de resposta de 300 segundos para o agente executar o trabalho, ou seja, 5 minutos.
Percebeu? Quem liga desliga em 2 minutos, mas quem atende acha que você tem paciência de 5 minutos. Resultado: a tarefa ainda está rodando, e a ligação já caiu. E o pior: esses 120 segundos estão hardcoded no código, usuário comum não acha onde alterar nem se quiser.
Causa 2: A Linha Antiga Não Tem Interruptor de “Timeout”
A segunda pegadinha é herança histórica.
O Hermes oferece duas formas de chamar o A2A: uma é a “transferência pela central” (chamada via peers configurados), e a outra é a “linha direta antiga” (chamada direta pela URL original). A linha antiga é resquício das versões iniciais, e ela também tem 120 segundos de timeout cravados no código interno, sem ler arquivo de configuração.
Ou seja, mesmo que você aprenda a alterar o timeout, a linha antiga simplesmente ignora. É como colocar pilha nova num telefone antigo, mas ele não tem botão de volume.
Causa 3: Na Hora, Joga o Resultado Fora
A terceira pegadinha é a mais cruel: o servidor faz uma “limpeza de área” na hora marcada.
Digamos que você finalmente aumentou o timeout do cliente e sobreviveu às duas primeiras. Aí o servidor resolve aprontar: quando a janela de resposta de 300 segundos expira, ele marca a tarefa como “falha”, mesmo com o agente ainda trabalhando duro. Pior: esse status de “falha” é pegajoso — gruda que nem cola. Quando o agente finalmente termina e volta com o resultado, descobre que ninguém está esperando, e o resultado é descartado.
É como o entregador que bate o ponto e vai embora: não importa se seu pacote chegou ou não, o sistema já mostra “falha na entrega”. No dia seguinte, quando você recebe o pacote, o rastreamento fica eternamente na coluna “falha”, sem volta.
Passo 1 da Investigação: Atrasar o Despertador
Entendendo as três pegadinhas, a correção fica simples.
A primeira correção é direta: mudar o timeout padrão do cliente de 120 para 330 segundos. 330 > 300 do servidor, assim quem liga tem mais paciência do que quem atende, e a tarefa sobrevive à janela de resposta do servidor. Além disso, o a2a_call ganhou um parâmetro de override de timeout por chamada — você pode definir o timeout individualmente para cada tarefa, sem alterar o global. E a linha antiga finalmente foi “modernizada”: agora ela lê a configuração e herda autenticação e timeout.
Passo 2 da Investigação: “Desanexar” em vez de “Falhar”
A segunda correção é mais inteligente. O servidor não marca mais a tarefa como falha quando o tempo esgota — ele faz uma “desanexação”. O que isso significa? É como uma fila de call center: se você não quer esperar mais, pode desligar, mas seu chamado continua no sistema, e quando for resolvido, você recebe um SMS.
Em termos práticos: quando a janela de resposta expira, quem chamou recebe um status não-terminal de “trabalhando”, com instruções. A tarefa permanece no estado WORKING, e o sistema agenda um “esperador limitado” para continuar monitorando. Quando o agente realmente termina, o resultado real é registrado. Depois disso, seja via tasks/get ou tasks/resubscribe, o observador consegue ver o resultado final. Resultado atrasado não é mais descartado.
Passo 3 da Investigação: Pegadinhas Vizinhas Corrigidas no Caminho
Resolvido o caso principal, ainda apareceram alguns problemas dos vizinhos.
Resposta de streaming truncada: antes, a resposta de streaming podia devolver só o último trecho para quem chamou. Por exemplo, um event_id longo era truncado e só sobrava o segundo pedaço, e quem chamava recebia informação incompleta. Agora a resposta acumulada é preservada integralmente, e nos testes, todos os 152 casos passaram.
Falso sucesso: quando o orçamento de iterações do agente esgotava, antes ele retornava um resumo “concluído”, mas o peer não conseguia distinguir “trabalho truncado” de “trabalho concluído com sucesso”, podendo aceitar resultado parcial como completo. Agora, tarefas truncadas reportam explicitamente TASK_STATE_FAILED, sem fingir sucesso.
Launcher externo: usuários não-root agora podem configurar um launcher de agente externo, rodando subprocessos ou workers RPC versionados, com suporte a saída limitada, colheita da árvore de processos, cancelamento e finalização exatamente-uma-vez. Isso resolve três problemas antigos: visibilidade da conclusão, alinhamento de timeout e continuidade multi-turno.
O Que Isso Significa para Você
Agora, delegar tarefas entre dois Hermes, mesmo acima de dois minutos, não é mais “falha garantida”. O timeout é ajustável, e a linha antiga obedece. Mais importante: mesmo que o servidor não aguente esperar, a tarefa não é “condenada à morte” — ela continua em estado de trabalho, registra o resultado normalmente quando termina, e você pode consultar quando quiser.
Tarefas longas finalmente são como uma corrida de longa distância: tem alguém cronometrando, alguém acompanhando, alguém registrando o resultado. Em vez de, como antes, o juiz apitar no meio do percurso e anular a prova.
📖 Documentação oficial
この記事は Hermes Agent のDocumentação oficialに基づいています:Documentação oficial › user-guide/messaging/a2a