Das Rätsel der A2A-Langzeitaufgaben: Warum Aufträge über zwei Minuten ständig scheitern
Hermes-Messaging-Plattform, Teil 38: Die dreifache Ursache des A2A-Timeout-Problems bei langlaufenden Aufgaben – und ihre Behebung.
Zwei Hermes-Instanzen auf verschiedenen Rechnern „telefonieren“ miteinander, um Aufgaben zu delegieren – und sobald eine Aufgabe länger als zwei Minuten dauert, schlägt sie fehl. Egal, was man an der Konfiguration dreht. Das ist keine Zauberei, sondern drei kleine Stolperfallen, die sich überlagern.
Das Rätsel: Der Zwei-Minuten-Fluch
Stell dir vor, du bittest Kollegin A, eine Datei für dich zu bearbeiten. Ihr seid so verabredet, dass sie dich anruft, sobald sie fertig ist. Doch jedes Mal, wenn das Gespräch länger als zwei Minuten dauert, wird bei dir „klack“ aufgelegt und „Anruf fehlgeschlagen“ angezeigt. Du probierst andere Telefone, andere Leitungen, sogar ein anderes Büro – das Problem bleibt.
Genau das erleben Hermes-Nutzer. Zwei Maschinen, auf jeder läuft ein Hermes, verbunden über das A2A-Plugin (Agent-to-Agent-Protokoll). Maschine A gibt Maschine B einen Auftrag. Dauert die Aufgabe länger als etwa zwei Minuten, schlägt sie garantiert fehl. In der Community heißt es dazu: „Long reply führt dazu, dass die Fortschrittsverfolgung kaputtgeht.“ Das Ärgerliche daran: Auf Maschine B ist die Arbeit längst erledigt, aber Maschine A bekommt das Ergebnis nie zu Gesicht.
Ursache 1: Der Anrufer hat keine Geduld
Die erste Falle ist schlicht ein „Ungedulds-Problem“.
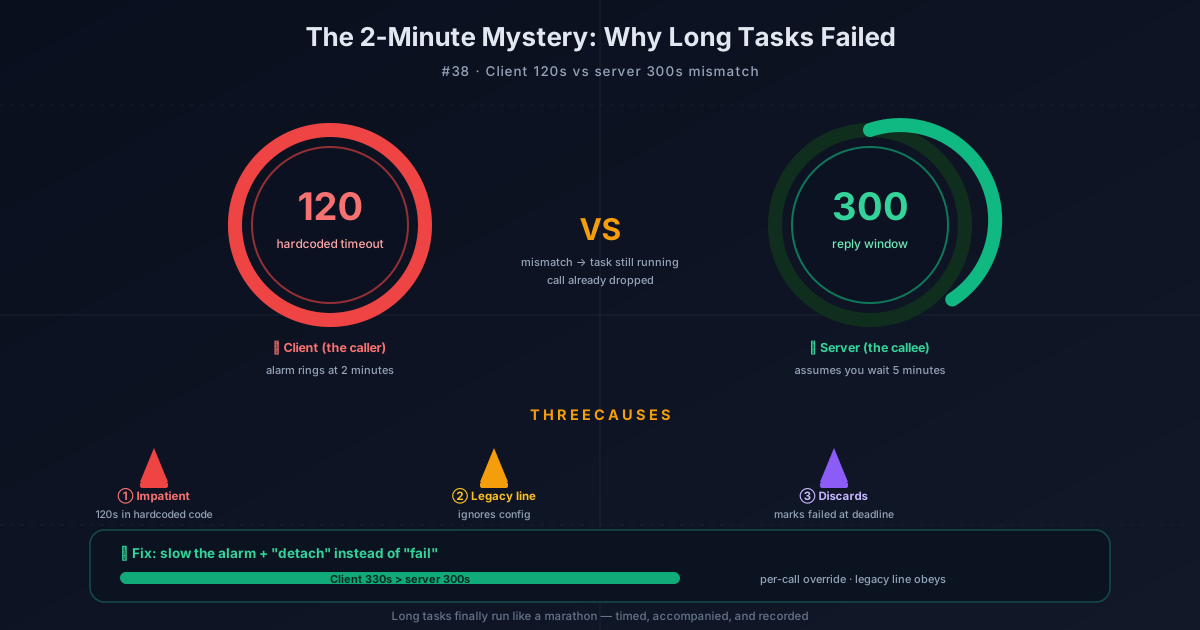
Der Hermes-Client hat eine Standard-Timeout-Einstellung – 120 Sekunden. Was bedeutet das? Der Anrufer stellt sich selbst einen Wecker: Wenn der Gesprächspartner nicht innerhalb von 120 Sekunden antwortet, lege ich auf. Und auf der Serverseite? Die reserviert für den Agenten ein Antwortfenster von 300 Sekunden, also 5 Minuten.
Siehst du das Problem? Der Anrufer legt nach 2 Minuten auf, während der Angerufene davon ausgeht, dass du 5 Minuten Geduld mitbringst. Die Folge: Die Aufgabe läuft noch, aber die Leitung ist schon tot. Und das Schlimmste: Diese 120 Sekunden sind fest im Code verdrahtet. Ein normaler Nutzer sucht vergeblich nach einer Stelle, um das zu ändern.
Ursache 2: Die alte Leitung hat keinen „Timeout“-Schalter
Die zweite Falle ist ein Relikt aus alten Zeiten.
Hermes bietet zwei Wege, A2A aufzurufen: den offiziellen Weg über die „Vermittlung“ (Aufruf über konfigurierte Peers) und den „direkten Draht in die Vergangenheit“ (Aufruf direkt über die rohe URL). Die alte Leitung stammt aus einer früheren Version. In ihrem Inneren ist ebenfalls ein 120-Sekunden-Timeout fest verdrahtet, und sie liest die Konfigurationsdatei nicht.
Das heißt: Selbst wenn du herausfindest, wie man das Timeout ändert, die alte Leitung ignoriert dich einfach. Als würdest du einem alten Telefon neue Batterien einbauen, aber es hat schlicht keinen Lautstärkeregler.
Ursache 3: Pünktlich wird das Ergebnis weggeworfen
Die dritte Falle ist die gemeinste: Der Server räumt pünktlich auf.
Angenommen, du hast es geschafft, das Client-Timeout zu vergrößern und die ersten beiden Fallen umgangen. Dann macht der Server wieder Ärger: Sobald das 300-Sekunden-Antwortfenster abläuft, markiert er die Aufgabe als „fehlgeschlagen“ – obwohl der Agent noch fleißig arbeitet. Schlimmer noch: Dieser „Fehlgeschlagen“-Status ist klebrig – wie Superkleber, den man nicht mehr loswird. Wenn der Agent endlich fertig ist und mit dem Ergebnis zurückkommt, wartet niemand mehr auf ihn. Das Ergebnis wird einfach verworfen.
Das ist, als ob der Paketbote pünktlich Feierabend macht. Egal, ob dein Paket zugestellt wurde oder nicht, das System zeigt erstmal „Zustellung fehlgeschlagen“ an. Wenn du das Paket am nächsten Tag bekommst, bleibt die Sendungsverfolgung für immer auf „Fehlgeschlagen“ stehen. Das lässt sich nicht mehr korrigieren.
Ermittlung Schritt 1: Den Wecker langsamer stellen
Wenn man die drei Fallen kennt, ist die Lösung einfach.
Die erste Korrektur ist simpel: Das Standard-Timeout des Clients von 120 Sekunden auf 330 Sekunden erhöhen. 330 Sekunden > die 300 Sekunden des Servers. So ist der Anrufer geduldiger als der Angerufene, und die Aufgabe überlebt das Antwortfenster des Servers. Gleichzeitig bekommt a2a_call einen Parameter für ein individuelles Timeout pro Aufruf – du kannst also für einzelne Aufgaben separat ein Timeout setzen, ohne alles global zu ändern. Und die alte Leitung wurde endlich „modernisiert“: Sie liest jetzt die Konfiguration und übernimmt Authentifizierungs- und Timeout-Einstellungen.
Ermittlung Schritt 2: Aufgabe „abtrennen“ statt „scheitern“
Die zweite Korrektur ist raffinierter. Der Server markiert die Aufgabe bei Ablauf des Fensters nicht mehr als fehlgeschlagen, sondern „trennt“ sie ab. Was bedeutet das? Wie bei einer Warteschleife im Kundenservice: Wenn du es leid bist zu warten, kannst du auflegen, aber dein Ticket bleibt im System. Wenn es bearbeitet ist, bekommst du eine SMS.
Konkret: Wenn das Antwortfenster abläuft, erhält der Aufrufer einen nicht-endgültigen Status „in Arbeit“ mit Hinweisen. Die Aufgabe bleibt im Status WORKING, und das System beauftragt einen „begrenzten Wartenden“ (bounded waiter), weiterhin ein Auge darauf zu haben. Wenn der Agent wirklich fertig ist, wird das echte Ergebnis festgehalten. Egal, ob man danach über tasks/get oder tasks/resubscribe nachfragt – der Beobachter sieht das Endergebnis. Verspätete Ergebnisse werden nicht mehr verworfen.
Ermittlung Schritt 3: Nebenbei mitgeflickte Fallen
Nach der Lösung des Hauptfalls sind noch ein paar Fallen bei den Nachbarn aufgefallen.
Abgeschnittene Streaming-Antworten: Früher konnte es passieren, dass bei einer Streaming-Antwort nur das letzte Fragment an den Aufrufer zurückgegeben wurde. Bei einer langen event_id-Kette blieb dann nur der zweite Teil übrig – der Aufrufer bekam verstümmelte Informationen. Nach dem Fix wird die kumulierte Antwort vollständig erhalten. Im Test sind alle 152 Fälle durchgelaufen.
Fake-Abschluss: Wenn das Iterationsbudget eines Agenten erschöpft war, wurde vorher eine „abgeschlossene“ Zusammenfassung zurückgegeben. Der Peer konnte aber nicht erkennen, ob die Arbeit „abgebrochen“ oder „erfolgreich abgeschlossen“ wurde – und akzeptierte womöglich Teilergebnisse als vollständiges Ergebnis. Jetzt melden abgebrochene Aufgaben explizit TASK_STATE_FAILED und geben sich nicht mehr als Erfolg aus.
Externe Starter: Nicht-Root-Nutzer können jetzt externe Agenten-Starter konfigurieren, um Subprozesse oder versionierte RPC-Worker auszuführen – mit begrenzter Ausgabe, Prozessbaum-Aufräumen, Abbruch und Exactly-Once-Terminierung. Damit sind drei alte Probleme gelöst: Sichtbarkeit des Abschlusses, Timeout-Angleichung und Kontinuität über mehrere Runden.
Was das für dich bedeutet
Jetzt können zwei Hermes-Instanzen Aufgaben delegieren, die länger als zwei Minuten dauern – ohne dass sie zwangsläufig scheitern. Das Timeout ist einstellbar, und auch die alte Leitung gehorcht jetzt. Wichtiger noch: Selbst wenn der Server nicht mehr warten kann, wird die Aufgabe nicht zum Tode verurteilt – sie bleibt im Arbeitsmodus, das Ergebnis wird nach Abschluss normal protokolliert, und du kannst es jederzeit abfragen.
Langzeitaufgaben sind jetzt wie ein langer Lauf: Jemand nimmt die Zeit, jemand läuft mit, jemand notiert die Leistung. Und nicht mehr wie früher: Mitten im Rennen pfeift der Schiedsrichter ab und die Leistung wird gestrichen.
📖 Offizielle Dokumentation
この記事は Hermes Agent のOffizielle Dokumentationに基づいています:Offizielle Dokumentation › user-guide/messaging/a2a