ปริศนางานระยะยาวของ A2A: ทำไมงานที่ใช้เวลาเกินสองนาทีถึงพังซ้ำแล้วซ้ำเล่า
Hermes แพลตฟอร์มข้อความ บทความที่ 38: สามสาเหตุและแนวทางแก้ไขปัญหา A2A งานระยะยาวหมดเวลา
Hermes บนเครื่องสองเครื่อง “โทรหากัน” เพื่อมอบหมายงาน พองานใช้เวลาเกินสองนาทีก็ล้มเหลว—จะปรับคอนฟิกยังไงก็ไม่ได้ผล นี่ไม่ใช่เรื่องความเชื่อโชคลาง แต่เป็นหลุมพรางสามอันซ้อนกันอยู่
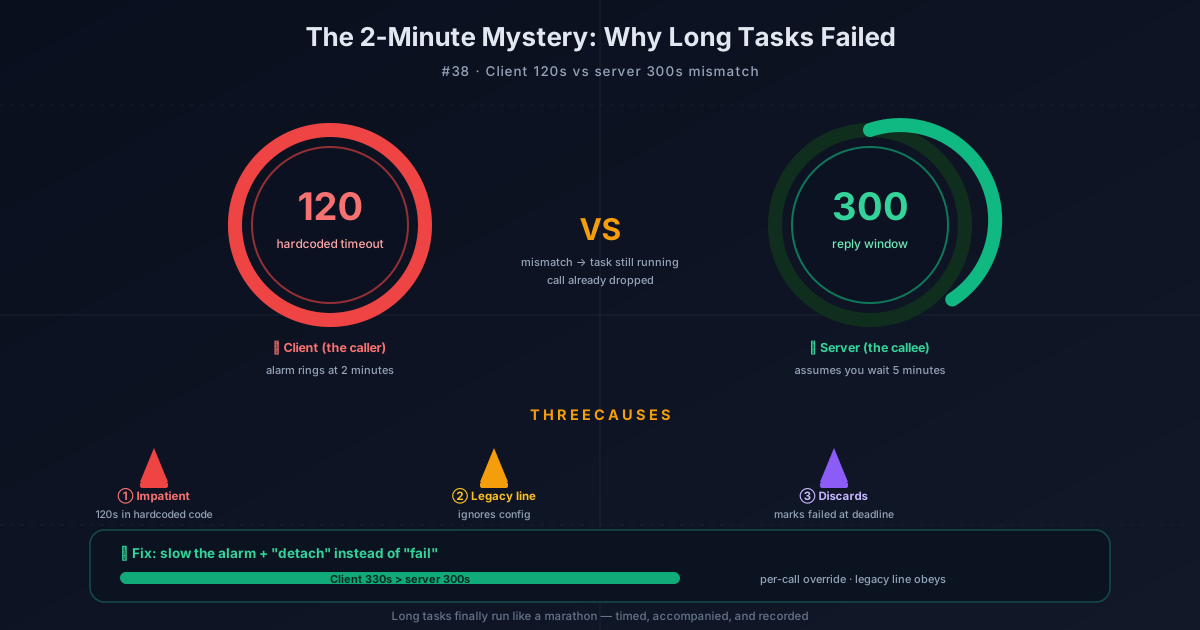
ปริศนา: คำสาปสองนาที
ลองนึกภาพว่าคุณให้เพื่อนร่วมงาน A ช่วยจัดการไฟล์หนึ่งชุด โดยตกลงกันว่าเขาทำเสร็จแล้วจะโทรมาบอกผล แต่ทุกครั้งที่สายเกินสองนาที ฝั่งคุณจะ “ปึ๊ง” วางสาย แล้วขึ้นว่า “สายล้มเหลว” คุณลองเปลี่ยนโทรศัพท์ เปลี่ยนสาย แม้แต่ย้ายออฟฟิศ ปัญหาก็ยังเหมือนเดิม
นี่คือสิ่งที่ผู้ใช้ Hermes เจอ เครื่องสองเครื่องแต่ละตัวรัน Hermes หนึ่งตัว เชื่อมต่อผ่านปลั๊กอิน A2A (โปรโตคอลการสื่อสารเปิดระหว่างเอเจนต์) เครื่อง A มอบหมายงานให้เครื่อง B พองานใช้เวลาเกินประมาณ 2 นาที ก็ล้มเหลวเสมอ ชุมชนเรียกสิ่งนี้ว่า “long reply ทำให้การติดตามความคืบหน้าพัง” ที่น่าหงุดหงิดกว่าคือ ฝั่งเครื่อง B ทำงานเสร็จแล้วจริง ๆ แต่เครื่อง A ไม่ได้รับผลลัพธ์เลย
สาเหตุที่หนึ่ง: คนโทรไม่มีความอดทน
หลุมแรก เป็นปัญหา “ใจร้อน” ล้วน ๆ
Hermes ไคลเอนต์มีค่าเริ่มต้น timeout—120 วินาที หมายความว่าอย่างไร? ก็คือคนโทรตั้งนาฬิกาปลุกให้ตัวเอง: ถ้าอีกฝ่ายไม่ตอบภายใน 120 วินาที ฉันจะวางสาย แต่ฝั่งเซิร์ฟเวอร์ล่ะ? มันเผื่อหน้าต่างตอบกลับให้เอเจนต์ทำงานไว้ 300 วินาที นั่นคือ 5 นาที
เห็นไหม คนโทรวางสายที่ 2 นาที แต่คนรับสายคิดว่าคุณมีความอดทน 5 นาที ผลลัพธ์ก็คือ: งานยังรันอยู่ สายขาดก่อน และ 120 วินาทีนี้ถูก hardcode ไว้ในโค้ด ผู้ใช้ทั่วไปหาที่แก้ไม่เจอด้วยซ้ำ
สาเหตุที่สอง: สายเก่าไม่มีสวิตช์ “timeout”
หลุมที่สอง เป็นปัญหาตกค้างจากอดีต
Hermes มีสองวิธีในการเรียก A2A: วิธีหนึ่งคือ “ผ่านสวิตช์บอร์ด” ทางการ (เรียกผ่าน peer ที่ตั้งค่าไว้) อีกวิธีคือ “สายตรงสายเก่า” (เรียกผ่าน URL ดิบโดยตรง) สายเก่าเป็นของที่เหลือจากเวอร์ชันเก่า ข้างในมันก็เขียน timeout 120 วินาทีตายตัว และไม่อ่านไฟล์คอนฟิก
พูดง่าย ๆ คือ ต่อให้คุณเรียนรู้วิธีแก้ timeout แล้ว สายเก่าก็ไม่ฟังคุณ เหมือนคุณใส่แบตเตอรี่ใหม่ให้โทรศัพท์รุ่นเก่า แต่มันไม่มีปุ่มปรับระดับเสียงให้หมุนเลย
สาเหตุที่สาม: ถึงเวลาแล้วทิ้งผลงาน
หลุมที่สามแสบที่สุด: ฝั่งเซิร์ฟเวอร์ “เก็บกวาด” เมื่อถึงเวลา
สมมติว่าคุณแก้ timeout ฝั่งไคลเอนต์ให้ใหญ่ขึ้นแล้ว ผ่านสองหลุมแรกมาได้ ผลปรากฏว่าฝั่งเซิร์ฟเวอร์มีเรื่องวุ่นวายอีก: พอหน้าต่างตอบกลับ 300 วินาทีหมดเวลา มันจะมาร์กงานเป็น “ล้มเหลว” ทันที ต่อให้เอเจนต์ยังก้มหน้าก้มตาทำงานอยู่ ยิ่งแย่ไปกว่านั้น สถานะ “ล้มเหลว” นี้เป็นแบบเหนียวหนึบ—เหมือนกาวที่สะบัดไม่ออก พอเอเจนต์ทำงานเสร็จจริง ๆ เอาผลลัพธ์กลับมา ปรากฏว่าไม่มีใครรอมันแล้ว ผลลัพธ์ถูกทิ้งทันที
เหมือนพนักงานส่งของเลิกงานตามเวลา ไม่ว่าพัสดุของคุณจะส่งถึงหรือไม่ ระบบขึ้น “ส่งไม่สำเร็จ” ก่อน พอวันรุ่งขึ้นคุณได้รับพัสดุ ข้อมูลโลจิสติกส์จะค้างอยู่ที่ช่อง “ล้มเหลว” ตลอดไป แก้กลับไม่ได้
ขั้นแรกในการคลี่คลาย: ทำนาฬิกาปลุกให้ช้าลง
พอเข้าใจสามหลุมแล้ว การแก้ก็ง่ายขึ้น
การแก้แรกตรงไปตรงมา: เปลี่ยนค่าเริ่มต้น timeout ของไคลเอนต์จาก 120 วินาทีเป็น 330 วินาที 330 วินาที > 300 วินาทีของฝั่งเซิร์ฟเวอร์ แบบนี้คนโทรจะอดทนกว่าคนรับสาย งานก็จะรอดผ่านหน้าต่างตอบกลับของเซิร์ฟเวอร์ และ a2a_call เพิ่มพารามิเตอร์ per-call timeout override—คุณสามารถตั้ง timeout เฉพาะงานเดียวได้ ไม่ต้องแก้ทั้งระบบ สายเก่าก็ “ทันสมัย” ในที่สุด ตอนนี้มันอ่านคอนฟิกแล้ว สืบทอดการรับรองความถูกต้องและการตั้งค่า timeout
ขั้นที่สองในการคลี่คลาย: “แยก” งานแทนที่จะ “ล้มเหลว”
การแก้ที่สองฉลาดกว่า ฝั่งเซิร์ฟเวอร์เมื่อถึงเวลา จะไม่มาร์กงานเป็นล้มเหลวอีกต่อไป แต่เป็น “แยก” หมายความว่าอย่างไร? เหมือนคิวสายบริการลูกค้า คุณรอนานเกินไปไม่อยากรอแล้ว วางสายได้ แต่ใบงานของคุณยังอยู่ในระบบ พอจัดการเสร็จจะมี SMS แจ้งคุณ
เจาะจงคือ: เมื่อหน้าต่างตอบกลับหมดเวลา ฝ่ายเรียกจะได้รับสถานะไม่สิ้นสุดแบบ “กำลังทำงาน” พร้อมคำแนะนำ งานยังคงอยู่ในสถานะ WORKING ระบบจัด “ผู้รอแบบมีขอบเขต” ให้คอยจับตาดูต่อไป พอเอเจนต์ทำงานเสร็จจริง ผลลัพธ์จริงจะถูกบันทึกไว้ หลังจากนั้นไม่ว่าจะสอบถามผ่าน tasks/get หรือ tasks/resubscribe ผู้สังเกตการณ์จะเห็นผลลัพธ์สุดท้าย ผลลัพธ์ที่มาสาย จะไม่ถูกทิ้งอีกต่อไป
ขั้นที่สามในการคลี่คลาย: หลุมข้างบ้านที่แก้ไปด้วย
แก้คดีหลักเสร็จ ยังเจอหลุมข้างบ้านอีกหลายอัน
การตัดทอนสตรีมตอบกลับ: ก่อนหน้านี้สตรีมตอบกลับอาจคืนแค่ส่วนสุดท้ายให้ฝ่ายเรียก เช่น event_id ยาว ๆ ถูกตัดเหลือแค่ส่วนที่สอง ฝ่ายเรียกได้ข้อมูลที่ไม่สมบูรณ์ หลังแก้แล้วเก็บสะสมตอบกลับทั้งหมดไว้ครบถ้วน ในการทดสอบ 152 เคสผ่านทั้งหมด
การเสร็จปลอม: เมื่องบประมาณการวนซ้ำของเอเจนต์หมด ก่อนหน้านี้จะคืนสรุปแบบ “เสร็จแล้ว” แต่ฝ่ายเพียร์ไม่เห็นความแตกต่างระหว่าง “งานที่ถูกตัดทอน” กับ “งานที่สำเร็จจริง” อาจรับผลลัพธ์บางส่วนเป็นผลลัพธ์เต็ม ตอนนี้งานที่ถูกตัดทอนจะรายงาน TASK_STATE_FAILED อย่างชัดเจน ไม่แสร้งเป็นความสำเร็จอีกต่อไป
ตัวเปิดใช้ภายนอก: ผู้ใช้ที่ไม่ใช่ root ตอนนี้สามารถตั้งค่าตัวเปิดใช้เอเจนต์ภายนอก รันซับโพรเซสหรือ RPC worker แบบมีเวอร์ชัน รองรับเอาต์พุตแบบมีขอบเขต การเก็บกวาดโพรเซสทรี การยกเลิก การสิ้นสุดแบบครั้งเดียวที่พอดี แก้ปัญหาความสามารถในการมองเห็นความสำเร็จ การจัดตำแหน่ง timeout และความต่อเนื่องหลายรอบ สามปัญหาเก่า
ความหมายสำหรับคุณ
ตอนนี้ การมอบหมายงานระหว่าง Hermes สองเครื่อง งานที่เกินสองนาทีไม่ “ล้มเหลวทุกครั้ง” อีกต่อไป timeout ปรับได้ สายเก่าก็เชื่อฟังแล้ว ที่สำคัญกว่า คือ ต่อให้เซิร์ฟเวอร์รอไม่ไหว งานก็ไม่ถูก “ตัดสินประหาร”—มันจะคงสถานะทำงานอยู่ พอทำงานเสร็จก็บันทึกผลลัพธ์ตามปกติ คุณสอบถามได้ตลอดเวลา
งานระยะยาวในที่สุดก็เหมือนการวิ่งมาราธอน มีคนจับเวลา มีคนวิ่งเป็นเพื่อน มีคนบันทึกผล แทนที่จะเป็นแบบเดิม วิ่งไปครึ่งทางโดนกรรมการเป่านกหวีด ผลงานเป็นโมฆะ
📖 เอกสารทางการ
この記事は Hermes Agent のเอกสารทางการに基づいています:เอกสารทางการ › user-guide/messaging/a2a