El misterio de las tareas largas en A2A: por qué fallan los trabajos de más de dos minutos
Integración de la plataforma de mensajería Hermes, artículo 38: Triple causa y solución del problema de tiempo de espera en tareas largas A2A.
Dos Hermes en máquinas distintas se “llaman por teléfono” para asignarse tareas, y todo lo que supera los dos minutos falla — por más que ajustes la configuración. No es brujería, son tres pequeños escollos apilados.
El enigma: la maldición de los dos minutos
Imagina que le pides a un compañero que te ayude con un documento, y quedan en que te llama cuando termine. Resulta que cada vez que la llamada pasa de dos minutos, tu lado “cuelga” de golpe y marca “llamada fallida”. Pruebas con otro teléfono, otra línea, incluso cambias de oficina, y el problema persiste.
Esto es exactamente lo que les pasa a los usuarios de Hermes. Dos máquinas, cada una con su Hermes, conectadas mediante el plugin A2A (protocolo abierto de comunicación entre agentes). La máquina A le asigna trabajo a la B, y si la tarea tarda más de unos 2 minutos, falla sí o sí. En la comunidad lo llaman “respuesta larga que rompe el seguimiento de progreso”. Lo más frustrante: del lado de B el trabajo sí se completa, pero A nunca recibe el resultado.
Causa uno: el que llama no tiene paciencia
El primer escollo es puro tema de “impaciencia”.
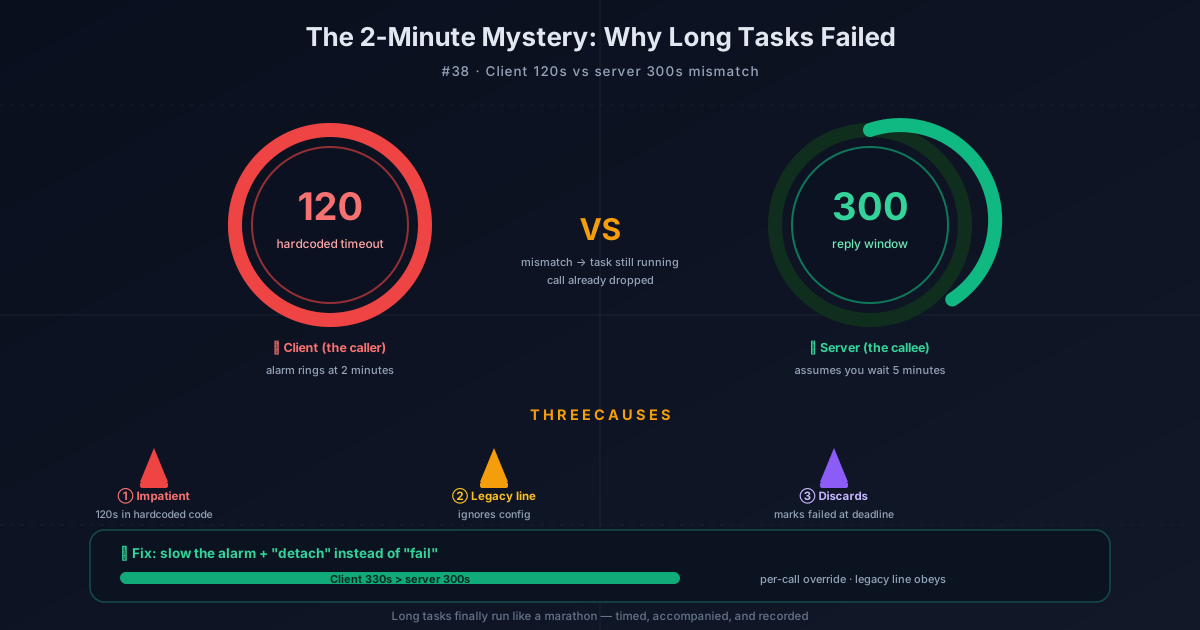
El cliente de Hermes tiene un timeout por defecto — 120 segundos. ¿Qué significa? Que el que llama se pone una alarma: si el otro no responde en 120 segundos, cuelgo. ¿Y el servidor? Él reserva una ventana de respuesta de 300 segundos para que el agente haga su trabajo, o sea 5 minutos.
¿Ves? El que llama cuelga a los 2 minutos, pero el que contesta cree que tienes paciencia para 5. Resultado: la tarea sigue corriendo, pero la llamada ya se cortó. Y lo peor: esos 120 segundos están hardcodeados en el código, un usuario normal no encuentra dónde cambiarlos ni buscando.
Causa dos: la línea vieja no tiene interruptor de “timeout”
El segundo escollo es herencia del pasado.
Hermes ofrece dos formas de invocar A2A: una es la “centralita oficial” (llamadas a través de pares configurados), y la otra es la “línea directa antigua” (invocación directa con la URL original). La línea vieja viene de versiones anteriores, y también tiene los 120 segundos grabados a fuego, sin leer archivo de configuración.
O sea, aunque aprendas a cambiar el timeout, la línea vieja no te hace caso. Es como ponerle pilas nuevas a un teléfono antiguo: no tiene perilla de volumen, y punto.
Causa tres: al llegar la hora, tiran el resultado a la basura
El tercer escollo es el más traicionero: el servidor “despeja el terreno” cuando se acaba el tiempo.
Digamos que por fin logras agrandar el timeout del cliente y sobrevives los dos primeros escollos. Ahora el servidor te sale con otra: cuando llega la ventana de 300 segundos, marca la tarea como “fallida”, aunque el agente siga dándole duro. Peor aún: ese estado de “fallida” es pegajoso — como pegamento, no se despega. Cuando el agente por fin termina y vuelve con el resultado, descubre que ya nadie lo espera, y el resultado se descarta directamente.
Es como el repartidor que se va a su hora, sin importar si tu paquete llegó o no: el sistema primero marca “entrega fallida”. Al día siguiente recibes el paquete, pero el seguimiento se queda para siempre en “fallida”, sin posibilidad de corregirlo.
Primer paso para resolver el caso: poner el despertador más lento
Una vez entendidos los tres escollos, arreglarlo es pan comido.
La primera solución es directa: cambiar el timeout por defecto del cliente de 120 a 330 segundos. 330 > 300 del servidor, así el que llama tiene más paciencia que el que contesta, y la tarea sobrevive la ventana de respuesta del servidor. Además, a2a_call ahora acepta un parámetro de timeout por llamada — puedes configurar el timeout para una tarea individual sin tocar el global. Y la línea vieja por fin se “modernizó”: ahora lee la configuración y hereda la autenticación y los ajustes de timeout.
Segundo paso: “separar” la tarea, no “fallarla”
La segunda solución es más elegante. Cuando expira la ventana de respuesta, el servidor ya no marca la tarea como fallida, sino como “separada”. ¿Qué significa? Como cuando llamas a soporte técnico y te cansas de esperar: puedes colgar, pero tu ticket sigue en el sistema, y te avisan por SMS cuando lo resuelvan.
En concreto: al expirar la ventana, el llamador recibe un estado no terminal de “en progreso”, con instrucciones adjuntas. La tarea se mantiene en estado WORKING, y el sistema asigna un “esperador acotado” para seguir vigilando. Cuando el agente realmente termina, el resultado real queda registrado. Después, ya sea consultando con tasks/get o tasks/resubscribe, el observador puede ver el resultado final. El resultado tardío ya no se descarta.
Tercer paso: escollos vecinos que se arreglaron de paso
Resuelto el caso principal, también salieron a la luz varios problemitas del vecindario.
Respuestas de streaming truncadas: antes, las respuestas de streaming podían devolver solo el último fragmento al llamador. Por ejemplo, un event_id largo se truncaba y solo llegaba la segunda parte, dejando al llamador con información incompleta. Ahora se conserva la respuesta acumulada completa, y en las pruebas pasaron los 152 casos de uso.
Falso completado: cuando el agente agotaba su presupuesto de iteraciones, antes devolvía un resumen “completado”, pero el par no podía distinguir entre “trabajo truncado” y “trabajo exitoso”, y podía aceptar un resultado parcial como si fuera completo. Ahora las tareas truncadas reportan explícitamente TASK_STATE_FAILED, sin disfrazarse de éxito.
Lanzador externo: los usuarios no root ahora pueden configurar un lanzador de agentes externo, ejecutar subprocesos o workers RPC versionados, con soporte para salida acotada, recolección del árbol de procesos, cancelación y terminación exactamente una vez. Se resolvieron tres problemas viejos: visibilidad de finalización, alineación de timeouts y continuidad multi-ronda.
Qué significa para ti
Ahora, cuando dos Hermes se asignan trabajo entre sí, las tareas de más de dos minutos ya no “fallan sí o sí”. El timeout es ajustable, y la línea vieja también obedece. Más importante aún: aunque el servidor se canse de esperar, la tarea no recibe “sentencia de muerte” — se mantiene en estado de trabajo, registra el resultado cuando termina, y puedes consultarlo cuando quieras.
Las tareas largas por fin son como correr un maratón: alguien cronometra, alguien acompaña, alguien registra la marca. Ya no es como antes, que a mitad de camino el árbitro pitaba y anulaban tu resultado.
📖 Documentación oficial
Este artículo se basa en la documentación oficial de Hermes Agent :Docs oficiales › user-guide/messaging/a2a