Il mistero delle attività A2A di lunga durata: perché i lavori oltre i due minuti falliscono sempre
Hermes Messaging Platform, articolo 38: tre cause e soluzioni per il timeout delle attività lunghe A2A.
Due Hermes su computer diversi si “chiamano” per assegnare compiti, e se l’attività supera i due minuti fallisce — qualsiasi configurazione si provi non funziona. Non è superstizione, sono tre piccole trappole che si sommano.
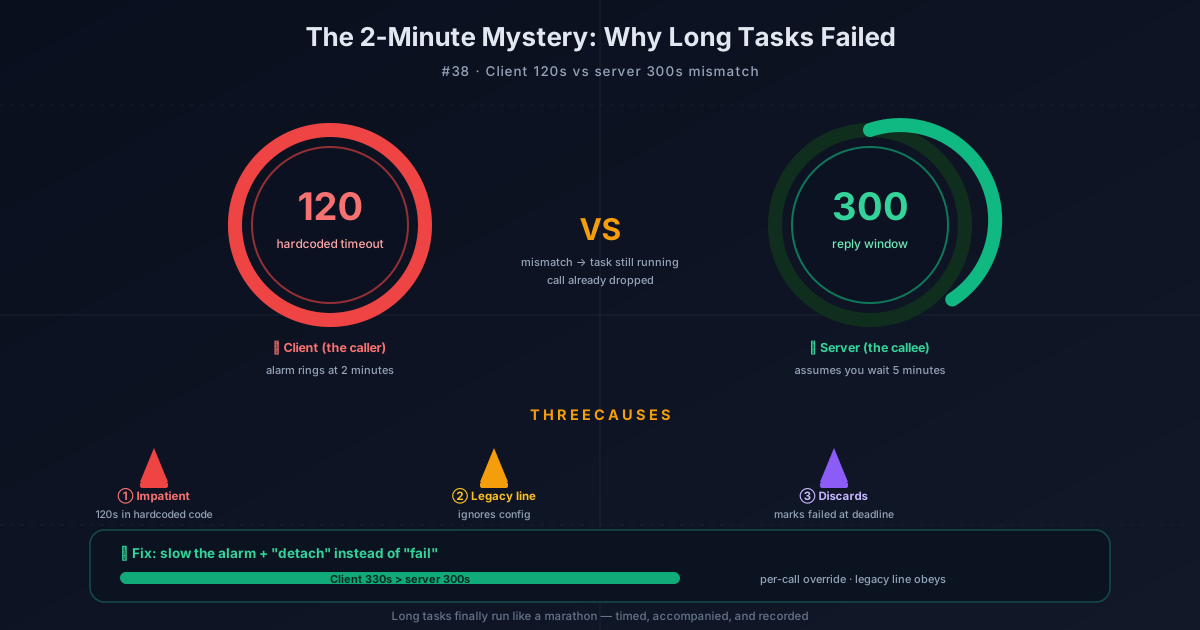
Il mistero: la maledizione dei due minuti
Immagina di chiedere a un collega di elaborare un documento, dicendogli di chiamarti quando ha finito. Ogni volta che la chiamata supera i due minuti, dall’altra parte “clic” — riattacca, e compare “chiamata fallita”. Provi a cambiare telefono, cambi linea, cambi persino ufficio, ma il problema resta.
È esattamente ciò che succede agli utenti di Hermes. Due macchine eseguono ciascuna un’istanza di Hermes, collegate tramite il plugin A2A (protocollo di comunicazione aperto tra agenti). La macchina A assegna un compito alla macchina B, e se l’attività richiede più di circa 2 minuti, fallisce inevitabilmente. Nella community lo chiamano “la risposta lunga che rompe il tracciamento dello stato”. La parte più frustrante? La macchina B in realtà ha completato il lavoro, ma la macchina A non riceve mai il risultato.
Causa uno: chi chiama non ha pazienza
La prima trappola è puramente un problema di “impazienza”.
Il client Hermes ha un timeout predefinito — 120 secondi. Cosa significa? Chi chiama si imposta una sveglia: se l’altra parte non risponde entro 120 secondi, riattacco. Ma il server? Lì la finestra di risposta riservata all’agente è di 300 secondi, cioè 5 minuti.
Vedi il problema? Chi chiama riattacca dopo 2 minuti, chi risponde pensa che tu abbia 5 minuti di pazienza. Risultato: l’attività è ancora in esecuzione, ma la chiamata è già caduta. E questo timeout di 120 secondi è hardcoded nel codice — un utente normale non trova nemmeno dove modificarlo.
Causa due: la vecchia linea non ha l’interruttore del “timeout”
La seconda trappola è un retaggio storico.
Hermes offre due modi per invocare A2A: uno è il “passaggio dal centralino” (chiamata tramite peer configurati), l’altro è la “linea diretta vecchio stile” (chiamata direttamente con URL originale). La vecchia linea è un residuo delle versioni precedenti: ha anch’essa un timeout di 120 secondi scritto a codice, e non legge i file di configurazione.
In pratica, anche se impari a modificare il timeout, la vecchia linea non ti ascolta. È come mettere batterie nuove a un telefono vecchio che non ha nemmeno la rotella del volume.
Causa tre: a scadenza, il risultato viene buttato via
La terza trappola è la più subdola: il server “sgombera” allo scadere.
Supponiamo che tu sia finalmente riuscito ad aumentare il timeout del client e abbia superato le prime due trappole. Ma il server fa di nuovo i capricci: quando scade la finestra di risposta di 300 secondi, marca l’attività come “fallita”, anche se l’agente sta ancora lavorando sodo. Peggio ancora, questo stato di “fallimento” è appiccicoso — come la colla, non si stacca. Quando l’agente finisce davvero e torna con il risultato, scopre che nessuno lo aspettava più, e il risultato viene scartato.
È come un corriere che timbra il cartellino e se ne va: che il pacco sia consegnato o no, il sistema mostra “consegna fallita”. Quando ricevi il pacco il giorno dopo, il tracking resta per sempre su “fallita”, impossibile da correggere.
Passo uno della soluzione: rallenta la sveglia
Una volta capite le tre trappole, la soluzione è semplice.
La prima correzione è diretta: cambiare il timeout predefinito del client da 120 a 330 secondi. 330 > 300 del server, così chi chiama ha più pazienza di chi risponde, e l’attività riesce a sopravvivere alla finestra di risposta del server. Inoltre, a2a_call ora supporta un parametro di timeout per singola chiamata — puoi impostare un timeout specifico per ogni attività senza modificare il globale. Anche la vecchia linea è stata finalmente “modernizzata”: ora legge la configurazione e eredita autenticazione e impostazioni di timeout.
Passo due della soluzione: “separazione” invece di “fallimento”
La seconda correzione è più intelligente. Allo scadere, il server non marca più l’attività come fallita, ma la “separa”. Cosa significa? È come il call center: se aspetti troppo in coda e non vuoi più aspettare, puoi riattaccare, ma il tuo ticket resta nel sistema — quando viene gestito, ricevi un SMS di notifica.
Nel concreto: quando scade la finestra di risposta, il chiamante riceve uno stato non terminale di “in lavorazione”, con relative istruzioni. L’attività resta in stato WORKING, e il sistema assegna un “osservatore con attesa limitata” che continua a monitorare. Quando l’agente finisce davvero, il risultato reale viene registrato. In seguito, sia tramite tasks/get che tasks/resubscribe, gli osservatori possono vedere il risultato finale. I risultati in ritardo non vengono più scartati.
Passo tre della soluzione: buche nel vicinato sistemate per strada
Risolto il caso principale, sono emerse anche altre buche dei vicini.
Risposte streaming troncate: prima, le risposte streaming potevano restituire solo l’ultimo frammento al chiamante. Per esempio, una lunga stringa di event_id veniva troncata e restava solo la seconda parte — il chiamante riceveva informazioni incomplete. Ora la risposta cumulativa viene conservata integralmente, e nei test tutti i 152 casi passano.
Completamento finto: quando il budget di iterazioni dell’agente si esaurisce, prima veniva restituito un riepilogo “completato”, ma il peer non poteva distinguere tra “lavoro troncato” e “lavoro completato con successo” — poteva accettare un risultato parziale come completo. Ora le attività troncate riportano esplicitamente TASK_STATE_FAILED, senza più fingersi riuscite.
Launcher esterni: gli utenti non-root ora possono configurare launcher di agenti esterni, eseguire sottoprocessi o worker RPC versionati, con supporto per output limitato, terminazione dell’albero dei processi, cancellazione e terminazione exactly-once. Risolti tre vecchi problemi: visibilità del completamento, allineamento dei timeout e continuità multi-round.
Cosa significa per te
Ora, quando due istanze di Hermes si assegnano compiti, le attività oltre i due minuti non falliscono più “per forza”. Il timeout è regolabile, e anche la vecchia linea ubbidisce. Ancora più importante: anche se il server non può più aspettare, l’attività non viene “condannata a morte” — resta in stato di lavoro, registra il risultato quando finisce, e puoi consultarlo quando vuoi.
Le attività lunghe finalmente sono come una maratona: qualcuno cronometra, qualcuno corre al tuo fianco, qualcuno registra il risultato. Non più come prima, quando a metà percorso l’arbitro fischiava e il risultato veniva annullato.
📖 Documentazione ufficiale
この記事は Hermes Agent のDocumentazione ufficialeに基づいています:Documentazione ufficiale › user-guide/messaging/a2a