A2A entre deux machines : faire collaborer deux Hermes sur des ordinateurs distincts
Hermes plateforme de messagerie intégration article 40 : étapes de déploiement inter-machines A2A et leçons réelles apprises sur les pièges rencontrés.
Un Hermes sur un ordinateur débordé, un autre Hermes sur une seconde machine qui vient donner un coup de main — c’est exactement à ça que sert A2A. Mais quels sont les pièges du déploiement ? Des utilisateurs réels les ont déjà rencontrés pour vous.
Quand a-t-on vraiment besoin de deux machines
Posons d’abord la bonne question : avez-vous réellement besoin de deux ordinateurs, ou simplement de faire collaborer deux agents ?
Si les deux agents vivent sur la même machine, la délégation ou un tableau de bord suffisent — c’est comme dans un même bureau : on interpelle son voisin de poste, pas besoin de passer un coup de fil. A2A est conçu pour le « multi-machine / multi-processus / multi-framework » : votre poste de travail et votre serveur font chacun tourner un Hermes, avec leurs propres mémoires, outils et identifiants de connexion. C’est là qu’A2A devient le pont indispensable.
Les étapes pour démarrer
Étape 1 : activer la plateforme A2A sur les deux machines. Lors de l’installation de Hermes, choisissez l’option A2A, ou modifiez le fichier de configuration en passant gateway.platforms.a2a.enabled à true. Le port par défaut est 9900. Cette étape revient à installer une porte d’entrée sécurisée sur chaque machine.
Étape 2 : configurer le token (la clé d’accès). Côté serveur, définissez A2A_PEER_TOKENS ou A2A_BEARER_TOKEN. Pour un simple test en local, on peut s’en passer, mais la porte ne sera ouverte qu’à 127.0.0.1 — comme un badge qui ne fonctionne que pour les résidents de l’immeuble.
Étape 3 : exposer l’adresse. Pour une communication inter-machines, il faut obligatoirement définir A2A_HOST, par exemple 0.0.0.0 ou l’adresse IP du réseau local. C’est le moment où l’on déplace la porte du « couloir interne » vers la « vitrine sur rue », pour que l’autre machine puisse vous trouver.
Étape 4 : apparier les pairs. Côté client, configurez a2a_agents, ou utilisez directement a2a_discover("http://adresse-du-serveur:9900") pour consulter l’Agent Card de l’autre — c’est comme tendre sa carte de visite pour vérifier qui est en face et quelles sont ses compétences.
Étape 5 : vérifier. Activez la boîte à outils a2a et envoyez une tâche simple avec a2a_call pour tester. Attention au délai d’expiration : le client attend 330 secondes par défaut, le serveur répond dans une fenêtre de 300 secondes. Pour les tâches longues, il faut augmenter ces valeurs, sinon le travail est interrompu en plein milieu. Une fois terminé, jetez un œil au journal d’audit dans ~/.hermes/a2a_audit.jsonl.
Cas réel n°1 : à quoi ressemble un déploiement réussi
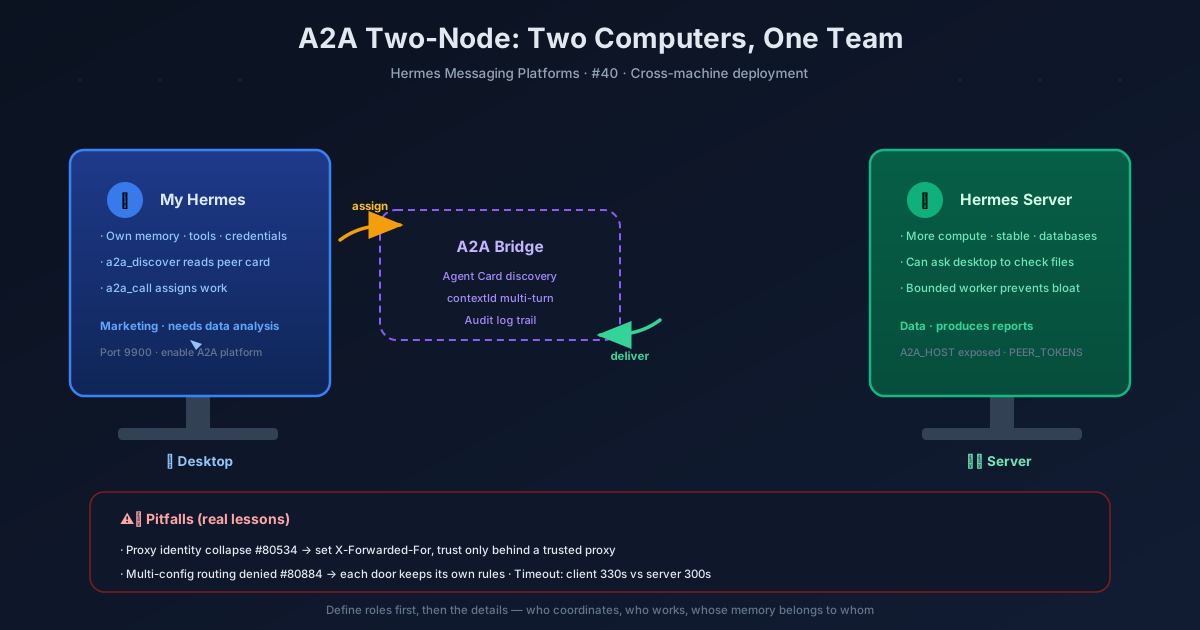
La documentation officielle décrit un scénario idéal : votre Hermes de bureau confie une tâche au Hermes du serveur — ce dernier dispose d’une puissance de calcul supérieure, d’un réseau plus stable et d’une base de données plus complète. À l’inverse, le Hermes du serveur peut déléguer au poste de travail des tâches comme « vérifie tel fichier en local ». Chacun garde sa mémoire et ses outils, chacun fait son travail, les compétences se découvrent mutuellement via l’Agent Card, les conversations sont indexées par contextId et supportent plusieurs tours.
C’est comme deux services dans une entreprise : le service marketing (le poste de bureau) a besoin d’un rapport d’analyse de données, il envoie un e-mail au service data (le serveur), qui le renvoie une fois terminé. Chacun archive de son côté, sans s’emmêler.
Cas réel n°2 : un déploiement qui a échoué
Un cas réel a été remonté par la communauté (#82910) : un utilisateur a déployé deux nœuds sur deux macOS — une passerelle orientée utilisateur + un worker. Sur le papier, ça ressemblait au cas réussi ci-dessus, mais le résultat a été un échec, et l’équipe a fini par décommissionner l’ensemble.
Le problème venait d’une mauvaise répartition des rôles entre « coordinateur » et « worker ». L’agent parent (le coordinateur) a entassé trop de choses dans sa propre session : chaque action du worker, chaque résultat intermédiaire, chaque étape de raisonnement revenait dans la session parente, provoquant une inflation du contexte — l’agent parent, submergé d’informations, devenait de plus en plus lent. Les transcriptions inter-agents plombaient les performances globales, et les tâches complexes déclenchaient des boucles de récupération qui enfonçaient encore plus le système.
La leçon est claire : avant de déployer A2A en multi-machine, il faut concevoir les frontières de responsabilité — qui coordonne, qui exécute, à qui appartient quelle mémoire. Ne mettez pas tout dans la session parente ; le worker doit avoir son propre « petit carnet ».
Liste des pièges à éviter lors du déploiement
Effondrement d’identité derrière un reverse proxy (#80534/#80779) : si vous utilisez nginx, un Ingress K8s ou un CDN comme reverse proxy, tous les pairs partagent le même bearer token et leurs identités se réduisent toutes à l’adresse du proxy. La solution : faire transmettre X-Forwarded-For par le proxy, et déduire l’identité réelle à partir des proxies de confiance. C’est comme la réception d’un immeuble qui reçoit les colis : il faut que le vrai destinataire soit écrit sur le paquet, sinon tout s’empile à l’accueil.
Routage refusé avec plusieurs profils de configuration (#80884/#80956) : si vous utilisez multiplex_profiles pour faire tourner plusieurs configurations, les messages A2A entrants routés vers un profil secondaire peuvent être rejetés par la couche d’autorisation de la passerelle. Le correctif consiste à capturer le contexte de sécurité de l’adaptateur immuable au démarrage, en conservant pour chaque profil ses propres politiques d’authentification, de confiance, de liaison et d’Agent Card. Chaque porte doit avoir ses propres règles d’accès, pas de passe-partout.
Délais d’expiration : 330 secondes côté client contre 300 secondes côté serveur par défaut. Pour les tâches longues, pensez à les augmenter. Sinon, c’est comme un appel longue distance : on vous coupe avant la fin de la phrase.
Mode worker borné (#82503) : c’est le remède officiel à l’inflation du contexte. Les routes A2A servies non-root peuvent exécuter des sous-processus de configuration ou des workers RPC versionnés, avec sortie bornée, récolte des processus, annulation et terminaison exactement une fois — le worker termine son travail et s’arrête, sans tout déverser dans la session parente.
Ce que cela signifie pour l’utilisateur
Un déploiement A2A sur deux machines ne se résume pas à « brancher deux ordinateurs ensemble ». C’est comme ouvrir une succursale : la vitrine (Agent Card), le sas d’entrée (token), la répartition des tâches (qui coordonne, qui exécute) et l’entrepôt (mémoires respectives) doivent tous être pensés en amont. Un déploiement réussi permet à chaque machine de mettre ses forces au service de l’autre ; un déploiement raté noie le coordinateur sous les informations.
Trois règles à retenir : définissez d’abord les frontières de responsabilité, ensuite seulement les détails techniques ; traitez la question de l’identité derrière les reverse proxies ; ajustez les délais pour les tâches longues et utilisez des workers bornés pour les tâches complexes. Si vous respectez ces points, les deux Hermes sur vos deux machines deviendront de vrais collègues — pas des coéquipiers qui se tirent vers le bas.
📖 Documentation officielle
Cet article est basé sur la documentation officielle de Hermes Agent :Docs officiels › user-guide/messaging/a2a