A2A 이중 머신 실전 가이드: 두 대의 컴퓨터에서 Hermes 서로에게 일 시키기
Hermes 메시지 플랫폼 연동 제40편: A2A 크로스 머신 배포 절차와 실제 겪은 함정 교훈.
한 대의 컴퓨터에서 돌아가는 Hermes가 버거워할 때, 다른 컴퓨터의 Hermes에게 도움을 요청하는 방법 — A2A가 바로 그런 용도다. 그런데 배포할 때 어떤 함정이 있을까? 실제 사용자가 이미 겪어봤다.
언제 두 대의 컴퓨터가 필요한가
먼저 한 가지를 확실히 짚고 넘어가자. 정말 두 대의 컴퓨터가 필요한 건지, 아니면 그냥 두 에이전트가 협업하게 하려는 건지?
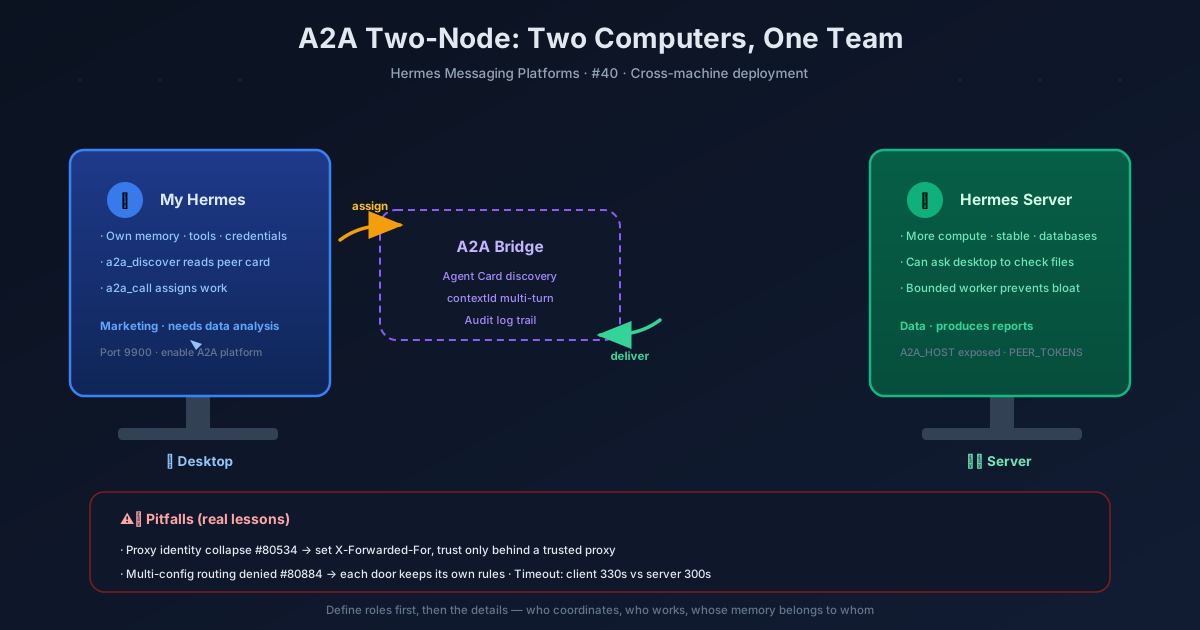
두 에이전트가 같은 머신에 있다면 위임(delegation)이나 칸반 보드로 충분하다 — 마치 같은 사무실에서 옆자리 동료에게 목소리만 높이면 되는 일에 굳이 전화를 걸 필요가 없는 것과 같다. A2A는 “크로스 머신/크로스 프로세스/크로스 프레임워크”를 위한 것이다: 데스크톱과 서버에 각각 Hermes가 떠 있고, 각자 고유한 메모리와 도구, 로그인 자격 증명을 갖고 있을 때, 그때서야 A2A라는 다리가 필요해진다.
시작하는 단계
1단계: 두 머신 모두 A2A 플랫폼을 활성화한다. Hermes 설치 시 A2A를 선택하거나, 설정 파일에서 gateway.platforms.a2a.enabled를 true로 바꾼다. 포트는 기본 9900. 이 단계는 각 컴퓨터에 출입 통제가 있는 대문을 하나씩 다는 것과 같다.
2단계: token(출입 키)을 설정한다. 서버 쪽에 A2A_PEER_TOKENS 또는 A2A_BEARER_TOKEN을 지정한다. 로컬 테스트만 한다면 token 없이도 되지만, 그 경우 대문은 127.0.0.1에게만 열린다 — 출입 카드를 같은 건물 입주민에게만 발급하는 것과 같다.
3단계: 주소를 노출한다. 크로스 머신이라면 반드시 A2A_HOST를 설정해야 한다. 예: 0.0.0.0 또는 LAN IP. 이 단계는 문을 “내부 통로”에서 “길가 위치”로 옮겨서 다른 컴퓨터가 당신을 찾을 수 있게 하는 것이다.
4단계: 피어를 페어링한다. 클라이언트 쪽에서 a2a_agents를 설정하거나, 바로 a2a_discover("http://서버주소:9900")로 상대방의 Agent Card를 확인한다 — 명함을 먼저 건네서 상대가 누구인지, 어떤 스킬을 갖췄는지 확인하는 것과 같다.
5단계: 검증한다. a2a 도구 모음을 활성화하고 a2a_call로 간단한 작업을 하나 던져 본다. 타임아웃에 주의: 클라이언트 기본 330초, 서버 응답 창 300초. 긴 작업은 값을 키워야 한다. 안 그러면 일이 절반쯤 진행됐을 때 타임아웃으로 처리된다. 완료 후 ~/.hermes/a2a_audit.jsonl에서 감사 로그를 확인한다.
실제 사례 1: 성공적인 배포는 이런 모습
공식 문서에는 이상적인 시나리오가 그려져 있다: 데스크톱의 Hermes가 서버의 Hermes에게 작업을 넘긴다 — 서버는 더 강한 연산력, 더 안정적인 네트워크, 더 완전한 데이터베이스를 갖고 있다. 반대로 서버의 Hermes도 “로컬 파일 좀 찾아봐” 같은 일을 데스크톱 쪽에 넘길 수 있다. 양쪽은 각자 메모리와 도구를 갖고 각자 일을 처리하며, Agent Card를 통해 서로의 스킬을 발견하고, 대화는 contextId를 기준으로 키잉되며, 다중 턴을 지원한다.
이건 한 회사의 두 부서와 같다: 마케팅 부서(데스크톱)가 데이터 분석 보고서가 필요하면 데이터 부서(서버)에 이메일을 보내고, 데이터 부서가 작업을 끝내면 돌려보낸다. 양쪽은 각자 아카이브를 보관하며 서로 간섭하지 않는다.
실제 사례 2: 실패한 배포
커뮤니티에 실제 사례가 하나 있다(#82910): 사용자가 두 대의 macOS에 듀얼 노드를 배포했다 — 사용자용 게이트웨이 + 워커 하나. 성공 사례와 비슷해 보였지만 결과는 실패였고, 결국 팀은 이 배포를 내렸다.
문제는 “코디네이터”와 “워커”의 역할 구분이 제대로 안 된 데 있었다. 부모 에이전트(코디네이터)가 자기 세션에 너무 많은 것을 쌓아버렸다: 워커의 매 단계 동작, 매 중간 결과, 매 사고 과정이 모두 부모 세션으로 역류하면서 **컨텍스트 팽창(context bloat)**이 발생했다 — 부모 에이전트가 엄청난 정보에 파묻혀 점점 둔해졌다. 크로스 에이전트 전사(transcript)가 전체 성능을 끌어내렸고, 복잡한 작업에서는 복구 루프까지 발생해 점점 더 깊이 빠져들었다.
교훈은 분명하다: A2A 크로스 머신 협업은 먼저 책임 경계를 설계해야 한다 — 누가 조정하고, 누가 일하고, 누구의 메모리가 누구 것인지. 모든 것을 부모 세션에 몰아넣지 말고, 워커는 자기만의 “작은 수첩”을 가져야 한다.
배포 시 함정 체크리스트
리버스 프록시 신원 붕괴(#80534/#80779): nginx, K8s Ingress 또는 CDN을 리버스 프록시로 쓰면 모든 피어가 동일한 bearer token을 공유하게 되어 신원이 전부 프록시 주소로 붕괴된다. 해결책은 프록시가 X-Forwarded-For를 전달하게 하고, 신뢰할 수 있는 프록시 이후부터 실제 신원을 유추하는 것이다. 이건 빌딩 로비에서 택배를 대신 받아주는 것과 같다. 포장지에 실제 수령인을 명확히 적어야지, 안 그러면 전부 로비에 쌓인다.
멀티 프로필 설정 라우팅 거부(#80884/#80956): multiplex_profiles로 여러 설정을 돌리면, 인바운드 A2A 메시지가 보조 프로필로 라우팅될 때 게이트웨이 인증 계층에서 거부될 수 있다. 수정 방법은 시작 시 불변 어댑터 보안 컨텍스트를 캡처해서 각 프로필의 인증, 신뢰, 바인딩, Agent Card 정책을 유지하는 것이다. 모든 문이 각자 고유한 출입 규칙을 가져야지, 하나를 공유하면 안 된다.
타임아웃 설정: 기본 330초(클라이언트) vs 300초(서버). 긴 작업은 반드시 조정하자. 안 그러면 장거리 전화를 하다가 말이 끝나기 전에 끊기는 것과 같다.
바운디드 워커 모드(#82503): 컨텍스트 팽창에 대한 공식 처방전이다. 루트가 아닌 served A2A 라우트는 설정의 서브프로세스 또는 버전화된 RPC 워커를 실행할 수 있으며, 바운디드 출력, 프로세스 트리 수확, 취소, 정확히 한 번의 종료를 지원한다 — 워커는 일이 끝나면 정리하고, 과정 전체를 부모 세션에 쏟아내지 않는다.
사용자에게 의미하는 것
A2A 이중 머신 배포는 “두 컴퓨터를 선으로 연결”하는 것보다 훨씬 복잡하다. 지점을 하나 여는 것과 같다: 간판(Agent Card), 출입 통제(token), 업무 분담(누가 조정하고 누가 일하는지), 창고(각자의 메모리)까지 모두 명확히 해야 한다. 성공적인 배포는 두 머신이 각자 강점을 발휘하게 하고, 실패한 배포는 코디네이터를 정보로 익사시킨다.
세 가지만 기억하자: 먼저 책임 경계를 명확히 하고, 그다음 기술 세부 사항을 고려할 것; 리버스 프록시는 신원 문제를 처리해야 할 것; 긴 작업은 타임아웃을 조정하고, 복잡한 작업은 바운디드 워커를 사용할 것. 이 세 가지만 지키면 두 컴퓨터의 Hermes는 진짜 좋은 동료가 될 수 있다. 서로를 끌어내리는 발목 잡는 팀원이 아니라.
📖 공식 문서
この記事は Hermes Agent の공식 문서に基づいています:공식 문서 › user-guide/messaging/a2a