第47篇:网络搜索与提取
Hermes 功能详解第47篇:Web Search & Extract。联网搜索、抓取网页。
這篇講的是如何讓 Hermes Agent 學會「上網衝浪」——既能搜尋資訊,又能抓取網頁內容,而且全程不需要你手動複製貼上。
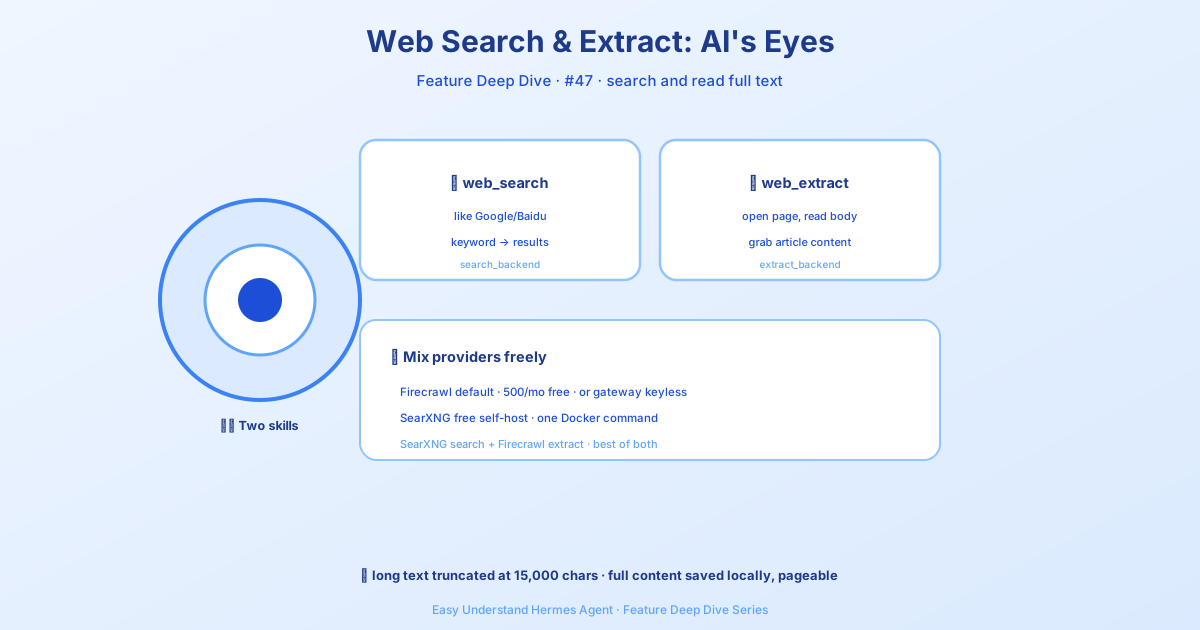
兩個核心技能
想像一下,Hermes Agent 是個能幹的助手,它有兩項看家本領:
web_search(搜尋):像打開百度/Google 一樣,輸入關鍵詞,返回排名結果。web_extract(提取):像打開某個網頁並「閱讀全文」,把正文內容抓取下來。
這兩項技能背後有多個「服務商」可選,就像你可以用 Chrome、Firefox 或 Safari 上網一樣。預設推薦 Firecrawl(免費額度每月 500 次),如果你有 Nous Portal 付費訂閱,甚至可以透過 Tool Gateway 免金鑰使用。
第1步:選擇你的「瀏覽器」
執行 hermes tools 指令,進入 Web Search & Extract 介面,按提示選擇服務商並填入 API 金鑰(金鑰在對應官網註冊取得)。
不想折騰? 直接選預設的 Firecrawl,在 ~/.hermes/.env 檔案裡加一行:
FIRECRAWL_API_KEY=fc-your-key-here想省錢? 用 SearXNG(免費、自架、注重隱私)。用 Docker 一條指令跑起來:
docker run -p 8888:8080 searxng/searxng:latest然後修改設定啟用 JSON 輸出(否則 Hermes 讀不了),最後在 config.yaml 裡指定:
web:
  search_backend: "searxng"
第2步:按需搭配「搜尋」和「提取」
搜尋和提取可以分開選不同的服務商。比如用免費的 SearXNG 搜尋,用 Firecrawl 提取網頁內容:
web:
  search_backend: "searxng"
  extract_backend: "firecrawl"
這就像用免費的圖書館查資料,但請付費的翻譯幫你精讀——各取所長。
第3步:理解「長文截斷」機制
網頁內容可能很長(比如論壇貼文、新聞留言區)。Hermes 預設只保留 15,000 字元(約 7500 個漢字),超出部分會截斷並提示 [TRUNCATED]。完整內容會存到本機檔案,Agent 可以按需分頁讀取。
如果截斷影響了你,可以調大限制:
web:
  extract_char_limit: 50000
或者改用 browser_navigate 工具直接操作瀏覽器,取得即時頁面。
第4步:驗證設定是否生效
設定好後,跑個測試搜尋:
curl -s "http://localhost:8888/search?q=test&format=json" | python3 -c "import sys,json; d=json.load(sys.stdin); print(len(d['results']), 'results')"看到 10 results 就說明 SearXNG 正常工作了。
總結一下:搜尋和提取是 Agent 的「眼睛」,選對服務商、配好金鑰、理解截斷機制,就能讓它幫你高效取得網路資訊。
下篇預告:Agent 能「看」能「搜」了,下一步該學「動手」——敬請期待第48篇:瀏覽器自動化操作。
📖 官方文档
本文根据 Hermes Agent 官方文档编写,原文见:官方文档 › user-guide/features/web-search