第17篇:批次處理——一次處理一大堆任務
Hermes 功能詳解第17篇:批次處理。把幾百條訊息一次丟給 AI,集中處理省時省力。
這篇講的是:如何讓 Hermes Agent 像流水線工人一樣,一次處理成百上千個任務,還能自動記錄全過程。
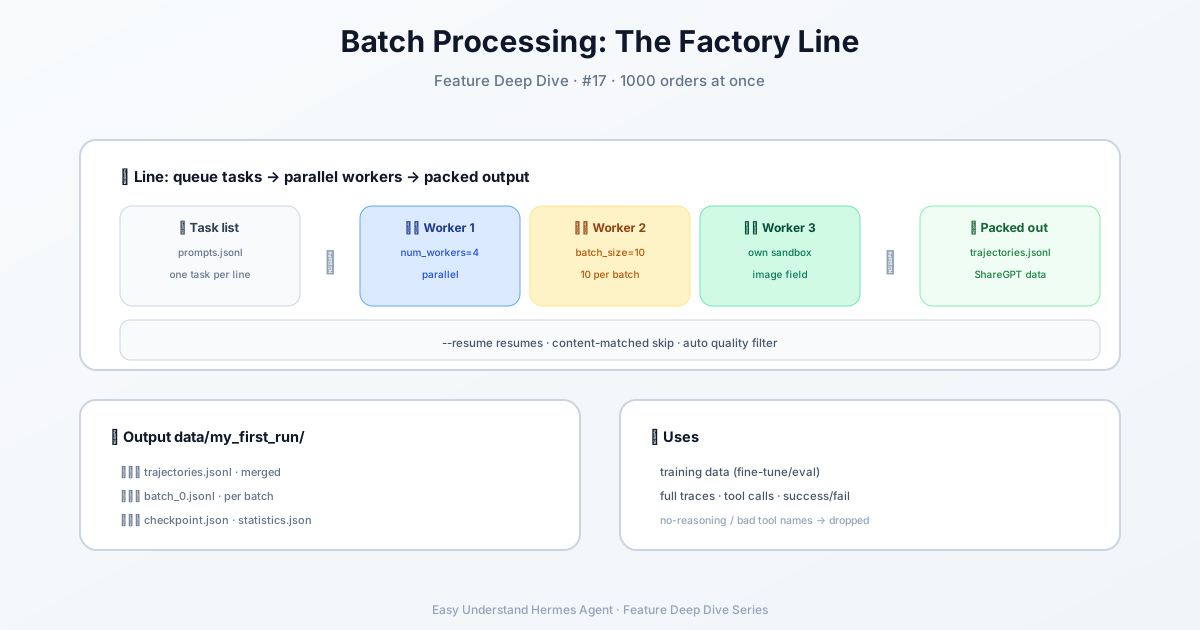
批次處理是什麼?
想像你有一家手工小作坊,平時接單都是一件一件做。現在突然來了 1000 個訂單,你不可能一個個手工完成——太慢了。批次處理就是給 Hermes Agent 裝上一條流水線:把一堆任務(prompts)排好隊,同時開好幾個工位(worker)並行處理,最後自動打包輸出結果。
這套功能主要用來生成訓練資料——也就是給 AI 模型「餵」的教材。每個任務都會記錄完整的對話過程、工具呼叫次數、成功失敗情況,格式是標準的 ShareGPT 格式,可以直接用來微調模型或做評測。
快速上手
第 1 步:準備任務清單
把你想讓 Agent 做的事寫進一個 JSONL 檔案(每行一個任務):
{"prompt": "寫一個Python函式,找出最長迴文子字串"}
{"prompt": "用Flask建立一個使用者登入的REST API介面"}
{"prompt": "修復這個報錯:TypeError: cannot unpack non-iterable NoneType object"}
第 2 步:執行批次處理
python batch_runner.py \
    --dataset_file=data/prompts.jsonl \
    --batch_size=10 \
    --run_name=my_first_run \
    --model=anthropic/claude-sonnet-4.6 \
--num_workers=4--batch_size:每批處理多少個任務--num_workers:同時開幾個「工位」(並行數)--run_name:這次執行的名稱,結果會存到data/my_first_run/資料夾裡
第 3 步:查看結果
執行完成後,打開 data/my_first_run/ 資料夾,你會看到:
data/my_first_run/
├── trajectories.jsonl    # 最終合併的所有結果
├── batch_0.jsonl         # 每批的單獨結果
├── checkpoint.json       # 斷點記錄(中斷後可以續跑)
└── statistics.json       # 統計資訊
中斷了怎麼辦?——斷點續跑
批次處理跑一半斷電了?別慌。加個 --resume 參數就能接著跑:
python batch_runner.py \
    --dataset_file=data/prompts.jsonl \
    --batch_size=10 \
    --run_name=my_first_run \
--resume它會自動掃描已完成的任務,只處理沒做完的部分。而且它是按任務內容比對的,就算你改了任務順序也能正確跳過。
每個任務用不同的環境
有些任務需要特殊環境?可以在任務裡指定容器映像檔:
{"prompt": "安裝numpy並計算3x3矩陣的特徵值", "image": "python:3.11-slim"}
{"prompt": "編譯這個Rust程式並執行", "image": "rust:1.75"}
每個任務就像在獨立的「小房間」裡執行,互不干擾。
自動品質過濾
批次處理跑完會自動丟掉「壞資料」:
- 沒有思考過程的樣本(AI 直接給答案沒推理)會被丟棄
- 工具名亂寫的樣本(呼叫了不存在的工具)會被過濾
這樣保證你拿到的資料都是高品質的。
小總結
批次處理就是把大量任務交給 Agent 並行處理,自動生成結構化訓練資料。核心優勢:並行高效、斷點續跑、自動品管、每個任務可獨立環境。適合生成訓練資料、模型評測、批次跑基準測試。
下篇預告:資料有了,怎麼餵給模型?下一篇我們聊聊「資料集處理與微調準備」——敬請期待!
📖 官方文档
本文根据 Hermes Agent 官方文档编写,原文见:官方文档 › user-guide/features/overview