Tutoriel 28 : Configuration des fournisseurs
Tutorial 28: Provider Configuration — easy-to-understand guide based on official docs
Tutoriel 28 : Configuration des fournisseurs
Bon retour ! Dans ce tutoriel, nous allons voir comment Hermes décide quel modèle d’IA fait quoi. Si vous vous êtes déjà demandé pourquoi certaines tâches semblent plus rapides que d’autres, ou comment rendre votre agent moins cher à faire fonctionner, ce tutoriel est fait pour vous.
Deux types d’emplacements de modèles
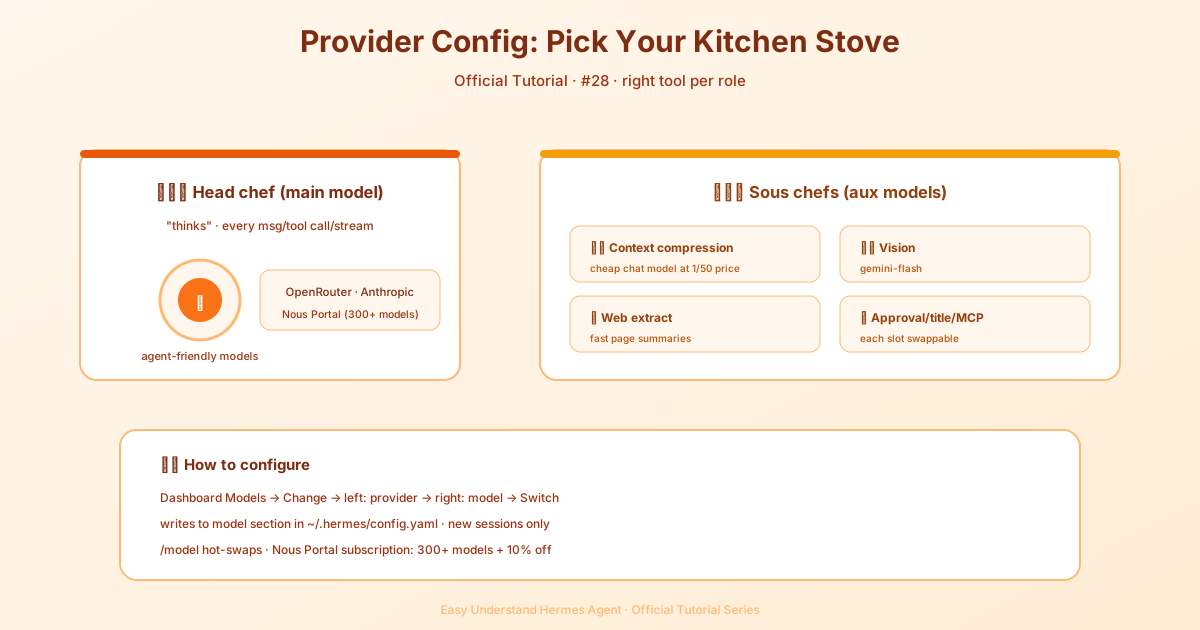
Imaginez Hermes comme une équipe. Vous avez votre modèle principal — la star qui gère chaque message utilisateur, chaque appel d’outil et chaque réponse en streaming. C’est le cerveau de votre agent.
Mais la star ne fait pas tout. Hermes délègue les tâches plus petites et répétitives à des modèles auxiliaires. Ce sont les seconds couteaux : compression de contexte, analyse d’images, résumé de pages web, notation d’approbation, routage des outils MCP, génération de titres de session et recherche de compétences. Chacune de ces 11 tâches a son propre emplacement, et vous pouvez les remplacer indépendamment.
Le chemin le plus rapide : Nous Portal
Avant d’entrer dans le vif du sujet, voici un raccourci. Nous Portal vous donne accès à plus de 300 modèles avec un seul abonnement. Sur une installation fraîche, il suffit d’exécuter :
hermes setup --portalCela vous connecte et définit Nous comme votre fournisseur en une seule commande. Curieux de voir ce qui est configuré ? Vérifiez avec hermes portal info. Les abonnés Portal bénéficient également de 10 % de réduction sur les fournisseurs facturés aux tokens, ce qui est un joli bonus.
La page Modèles
Ouvrez votre tableau de bord et cliquez sur Modèles dans la barre latérale. Vous verrez deux sections :
- Paramètres des modèles — le panneau supérieur où vous assignez des modèles aux emplacements.
- Analytiques d’utilisation — des cartes classées montrant chaque modèle qui a exécuté une session, avec les compteurs de tokens, le coût et les badges de capacités.
La ligne principale montre ce que votre agent utilisera pour les nouvelles sessions. Cliquez sur Changer pour ouvrir le sélecteur.
Définir le modèle principal
Le sélecteur a deux colonnes :
- Gauche — vos fournisseurs authentifiés. Seuls les fournisseurs que vous avez configurés (clé API, OAuth ou endpoint personnalisé) apparaissent ici. Il en manque un ? Rendez-vous dans Clés et ajoutez la référence.
- Droite — la liste de modèles organisée pour ce fournisseur. Ce sont les modèles agentiques qu’Hermes recommande, pas la liste brute
/models(qui sur OpenRouter inclut plus de 400 modèles, y compris des générateurs TTS et d’images).
Choisissez un modèle, cliquez sur Changer, et Hermes l’écrit dans ~/.hermes/config.yaml. Important : cela ne s’applique qu’aux nouvelles sessions. Vos onglets de chat ouverts continuent avec leur modèle d’origine. Pour changer à chaud le chat en cours, utilisez la commande /model à l’intérieur de celui-ci.
Changements en cours de session : ce qu’il faut savoir
Changer de modèle en pleine conversation ? Hermes estimera si votre prochain message déclenche une compression de contexte par rapport à la fenêtre du nouveau modèle. Si vous êtes proche du seuil, vous verrez un avertissement — mais le changement s’applique quand même immédiatement.
Grand avertissement : les changements en cours de session réinitialisent le cache de prompt. Les caches sont liés au modèle qui sert la requête, donc tout changement signifie que le prochain message relira toute la conversation au prix plein des tokens d’entrée au lieu du tarif en cache (environ 75 à 90 % de réduction). Sur une longue session, cette relecture unique peut coûter plus cher que la différence par token entre les modèles. Changez quand vous en avez besoin, mais préférez le faire tôt dans une conversation.
Niveaux d’entraînement sur données sans surveillance
Certains modèles (comme muse-spark-1.2-contributor) sont remisés parce que le fournisseur peut entraîner sur vos données. La sélection interactive affiche toujours une invite de confirmation. Mais les chemins non interactifs — comme les workers Kanban et les agents cron — échouent par sécurité car ils ne peuvent pas demander.
Si cela vous convient pour les charges de travail sans surveillance, enregistrez une reconnaissance persistante :
hermes config set security.allow_data_training_tiers_noninteractive trueHermes affiche toujours l’avertissement complet de politique de données à chaque démarrage sans surveillance, donc les journaux conservent une piste d’audit. Révoquez avec :
hermes config unset security.allow_data_training_tiers_noninteractiveDéfinir les modèles auxiliaires
Cliquez sur Afficher les auxiliaires pour révéler les 11 emplacements de tâches. Chaque tâche auxiliaire est par défaut sur auto — ce qui signifie qu’Hermes essaie aussi votre modèle principal pour ce travail. Si cette route échoue, auto suit les chaînes de repli spécifiques à la tâche, puis vos fallback_providers principaux, puis la chaîne de découverte intégrée d’Hermes.
Remplacez une tâche spécifique lorsque vous voulez un modèle moins cher ou plus rapide pour un travail secondaire. C’est un excellent moyen d’économiser des tokens sur les tâches répétitives.
Une dernière note sur le schéma model:
Sur une toute nouvelle installation, votre config a model: "" — une chaîne vide signifiant « pas encore configuré ». La première fois que vous exécutez hermes setup ou hermes model, cette clé passe à un mapping avec les sous-clés provider, default, base_url et api_mode. Si vous voyez une chaîne vide dans config.yaml, exécutez simplement hermes model (ou cliquez sur Changer dans le tableau de bord) et Hermes écrira la forme de dictionnaire appropriée pour vous.
Voilà ! Vous savez maintenant comment configurer vos modèles principal et auxiliaires. La prochaine fois, nous explorerons les fournisseurs de repli — pour que votre agent ne tombe jamais en panne.
📖 Documentation officielle
Cet article est basé sur la documentation officielle de Hermes Agent :Docs officiels › user-guide/configuring-models