استخراج المستندات — من الماسحات الضوئية إلى النص
استخراج المستندات — من الماسحات الضوئية إلى النص — دليل سهل الفهم بناءً على الوثائق الرسمية
تخيّل أن تُسلّم زميلك عقدًا، فيقلّب صفحاته ويقول: “هذا كله صور، لا أستطيع قراءة كلمة واحدة.” هذه هي بالضبط المشكلة التي نحلّها اليوم. أداة read_file في Hermes Agent أصبحت الآن قادرة على “فتح” الملفات مثل الإنسان — تحويل ملفات PDF ومستندات Word وجداول Excel وحتى ملفات Office القديمة إلى نصٍّ واضح يمكنها فهمه فعليًا.
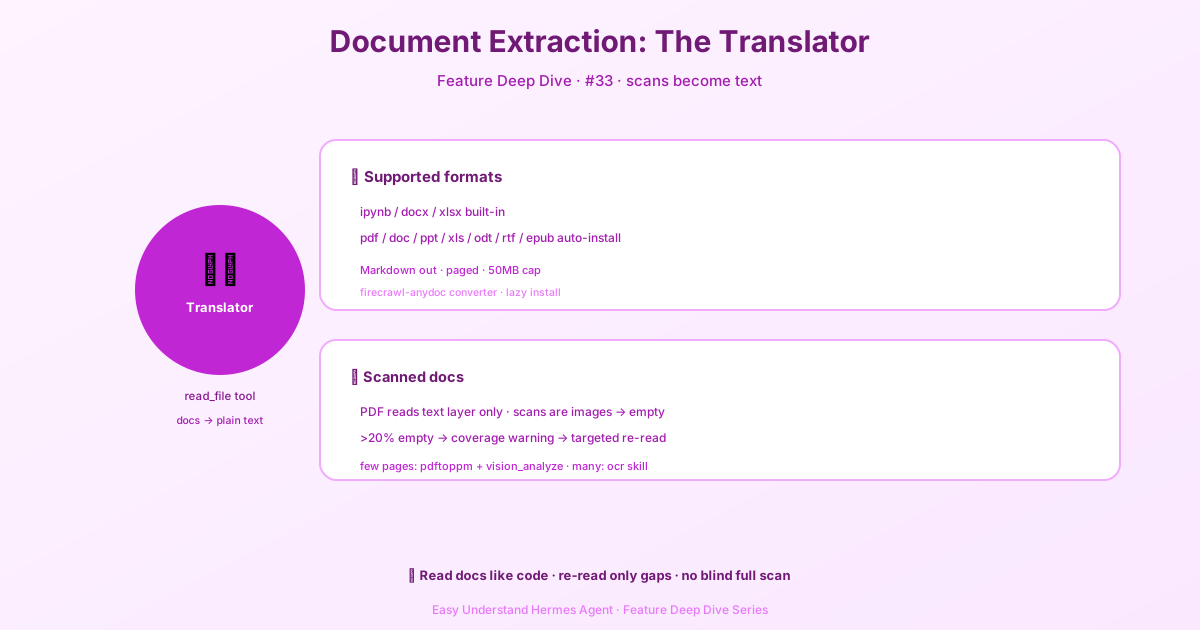
ثلاثة صيغ، بدون أي إعداد
الصيغ الأكثر شيوعًا تعمل مباشرةً، دون الحاجة إلى تثبيت أي شيء:
- دفاتر Jupyter (
.ipynb) - مستندات Word (
.docx) - جداول Excel (
.xlsx)
تتحوّل هذه إلى نص Markdown وتدعم القراءة على دفعات عبر معاملَي offset و limit — تمامًا مثل تقليب صفحات كتاب، صفحةً صفحة.
كل شيء آخر: تثبيت تلقائي، لا داعي للقلق
بالنسبة لملفات PDF وملفات Office القديمة (.doc, .ppt, .xls) وصيغة OpenDocument والكتب الإلكترونية (.epub)، يقوم Hermes تلقائيًا بتثبيت محوّل باسم firecrawl-anydoc عند أول استخدام. دون أن ترفع إصبعك.
ملاحظة واحدة: إذا كان إعداد نظامك يعطّل التثبيت التلقائي (security.allow_lazy_installs مضبوط على false)، فستعمل الصيغ الثلاث المدمجة فقط — وكل ما عداها سيُعامل كملف ثنائي. أيضًا، تُرفض الملفات الأكبر من 50 ميجابايت لتجنّب أوقات المعالجة الطويلة جدًا.
يعمل في البيئات البعيدة أيضًا
سواءً كان كودك يعمل على Docker أو Modal أو خادم SSH بعيد، يتم نقل الملفات تلقائيًا إلى جهازك المحلي لإجراء التحويل. قراءة مستند في بيئة معزولة (Sandbox) تعمل تمامًا مثل القراءة محليًا.
التحذير الكبير: الملفات الممسوحة ضوئيًا هي “PDF زائف”
هنا المأزق: تحويل PDF يقرأ فقط طبقة النص. إذا كان ملف PDF عبارة عن مسح ضوئي (عقود ورقية، فاكسات، مستندات موقّعة)، فكل شيء عبارة عن صور — لا توجد طبقة نص — وستكون النتيجة فارغة.
يكتشف Hermes هذا بذكاء: إذا كانت أكثر من 20% من الصفحات لا تُنتج نصًا (أو أكثر من 10 صفحات بالقيمة المطلقة)، فإنه يُضيف تحذيرًا في البداية يُظهر الصفحات الفارغة وآخر نص ظهر قبلها.
على سبيل المثال:
[EXTRACTION COVERAGE WARNING: 198 of 311 pages in this PDF yielded no text...
  pages 42-77 (36 pages) — after "Antigua Maintenance Corp Bylaws" (p41)
  pages 92-213 (122 pages) — after "... Covenants, Codes and Regulations" (p91)]
طريقتان لحل المشكلة
الحالة 1: بضع صفحات فقط ممسوحة ضوئيًا — استخدم العرض + الرؤية الحاسوبية. حوّل تلك الصفحات إلى صور:
pdftoppm -jpeg -r 150 -f 92 -l 94 document.pdf /tmp/pageثم استخدم أداة vision_analyze “للنظر” إلى الصور. يتطلب هذا تثبيت أدوات poppler على نظامك (والتي يستخدمها Hermes للكشف على أي حال).
الحالة 2: معظم الصفحات ممسوحة ضوئيًا — استخدم OCR للتعرف على الدفعات. لدى Hermes مهارة ocr-and-documents مبنية على marker-pdf، تدعم أكثر من 90 لغة وتتعامل مع المعادلات والجداول. تحتاج إلى 3–5 جيجابايت من مساحة القرص لتثبيتها.
الخلاصة
read_file تتيح للذكاء الاصطناعي قراءة كل صيغ المستندات الشائعة تقريبًا — لكن تذكّر: ملف PDF يحتاج إلى طبقة نص ليُقرأ مباشرةً. نصيحة عملية: إذا كنت تتعامل مع الملفات الممسوحة ضوئيًا بشكل منتظم، ثبّت مهارة OCR مسبقًا. إذا صادفت بضع صفحات ممسوحة فقط بين الحين والآخر، استخدم pdftoppm لتحويل الصور + تحليل الرؤية. لا تجعل الذكاء الاصطناعي يقرأ مستندًا كاملًا عبر OCR بشكل أعمى — اقرأ التحذير أولًا، وعالج فقط الصفحات الفارغة حقًا، ووفّر الوقت والجهد.
📖 التوثيق الرسمي
この記事は Hermes Agent のالتوثيق الرسميに基づいています:التوثيق الرسمي › user-guide/features/document-extraction