문서 추출 — 스캔을 텍스트로
문서 추출 — 스캔을 텍스트로 — 공식 문서 기반 이해하기 쉬운 가이드
문서 추출 — 스캔을 텍스트로
동료에게 계약서를 건네줬는데, 훑어보더니 “이거 전부 그림이잖아, 한 글자도 못 읽겠어”라고 말하는 상황을 상상해보세요. 오늘 우리가 해결할 문제가 바로 이것입니다. Hermes Agent의 read_file 도구는 이제 사람처럼 파일을 “열어서” PDF, Word 문서, Excel 시트, 심지어 구형 Office 파일까지 실제로 이해할 수 있는 일반 텍스트로 변환합니다.
세 가지 형식, 설정 제로
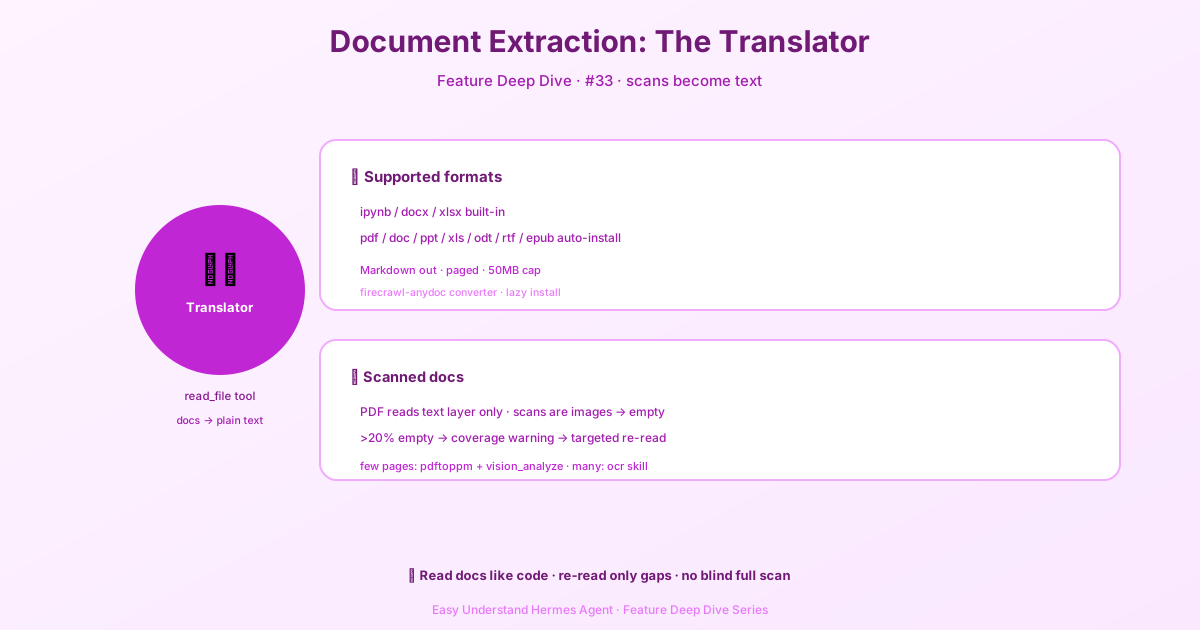
가장 흔한 형식들은 별도 설치 없이 바로 사용할 수 있습니다:
- Jupyter 노트북 (
.ipynb) - Word 문서 (
.docx) - Excel 스프레드시트 (
.xlsx)
이들은 Markdown 텍스트로 변환되며, offset 및 limit 파라미터를 통한 페이지 단위 읽기를 지원합니다 — 책을 한 장씩 넘기는 것과 똑같이요.
그 외 모든 것: 자동 설치, 걱정 없음
PDF, 구형 Office 파일 (.doc, .ppt, .xls), OpenDocument, 전자책 (.epub)의 경우, Hermes는 첫 사용 시 firecrawl-anydoc이라는 변환기를 자동으로 설치합니다. 손가락 하나 까딱할 필요가 없습니다.
한 가지 주의사항: 시스템 설정에서 자동 설치가 비활성화되어 있다면 (security.allow_lazy_installs가 false로 설정된 경우), 세 가지 내장 형식만 작동하고 나머지는 모두 바이너리로 처리됩니다. 또한 50MB를 초과하는 파일은 처리 시간이 너무 길어질 수 있어 거부됩니다.
원격 환경에서도 동일하게 작동
코드가 Docker, Modal 또는 SSH 원격 서버에서 실행되더라도, 파일은 자동으로 로컬 머신으로 전송되어 변환됩니다. 샌드박스에서 문서를 읽는 것은 로컬에서 읽는 것과 완전히 동일하게 작동합니다.
가장 중요한 경고: 스캔은 “가짜 PDF”입니다
여기가 함정입니다: PDF 변환은 텍스트 레이어만 읽습니다. PDF가 스캔본(종이 계약서, 팩스, 서명된 문서)이라면 전부 이미지일 뿐 — 텍스트 레이어가 없어서 결과물은 빈 텍스트가 됩니다.
Hermes는 이를 지능적으로 감지합니다: 페이지의 20% 이상이 텍스트를 생성하지 못하면(또는 절대 기준 10페이지 초과), 어떤 페이지가 비어 있는지와 그 앞에 마지막으로 나타난 텍스트를 보여주는 경고를 앞부분에 추가합니다.
예를 들어:
[추출 범위 경고: 이 PDF의 311페이지 중 198페이지가 텍스트를 생성하지 못했습니다...
  페이지 42-77 (36페이지) — "Antigua Maintenance Corp Bylaws" (p41) 이후
  페이지 92-213 (122페이지) — "... Covenants, Codes and Regulations" (p91) 이후]
해결 방법 두 가지
사례 1: 일부 페이지만 스캔인 경우 — 렌더링 + 비전 사용. 해당 페이지를 이미지로 변환하세요:
pdftoppm -jpeg -r 150 -f 92 -l 94 document.pdf /tmp/page그런 다음 vision_analyze 도구를 사용해 이미지를 “살펴보세요”. 이를 위해서는 시스템에 poppler 도구가 설치되어 있어야 합니다 (Hermes가 어차피 감지에 사용하는 도구입니다).
사례 2: 대부분의 페이지가 스캔인 경우 — 일괄 인식을 위해 OCR 사용. Hermes에는 marker-pdf 기반의 ocr-and-documents 스킬이 있으며, 90개 이상의 언어를 지원하고 수식과 표도 처리합니다. 설치에는 3~5GB의 디스크 공간이 필요합니다.
요약
read_file을 사용하면 AI가 거의 모든 일반적인 문서 형식을 읽을 수 있습니다 — 하지만 기억하세요: PDF를 직접 읽으려면 텍스트 레이어가 필요합니다. 실용적인 조언: 스캔 문서를 정기적으로 다룬다면 OCR 스킬을 미리 설치하세요. 가끔 몇 페이지의 스캔만 만난다면 pdftoppm으로 이미지를 변환하고 비전 분석을 사용하세요. AI가 문서 전체를 무작정 OCR하게 하지 말고 — 먼저 경고를 읽고, 실제로 빈 페이지만 처리하면 시간과 노력을 모두 절약할 수 있습니다.
📖 공식 문서
この記事は Hermes Agent の공식 문서に基づいています:공식 문서 › user-guide/features/document-extraction