Extração de Documentos — Digitalizações para Texto
Extração de Documentos — Digitalizações para Texto — guia fácil de entender com base na documentação oficial
Imagine entregar um contrato a um colega, e ele folheia dizendo: “Isso é tudo imagem, não consigo ler uma palavra.” Esse é exatamente o problema que estamos resolvendo hoje. A ferramenta read_file do Hermes Agent agora consegue “abrir” arquivos como um humano — transformando PDFs, documentos do Word, planilhas do Excel e até arquivos Office legados em texto puro que ele realmente entende.
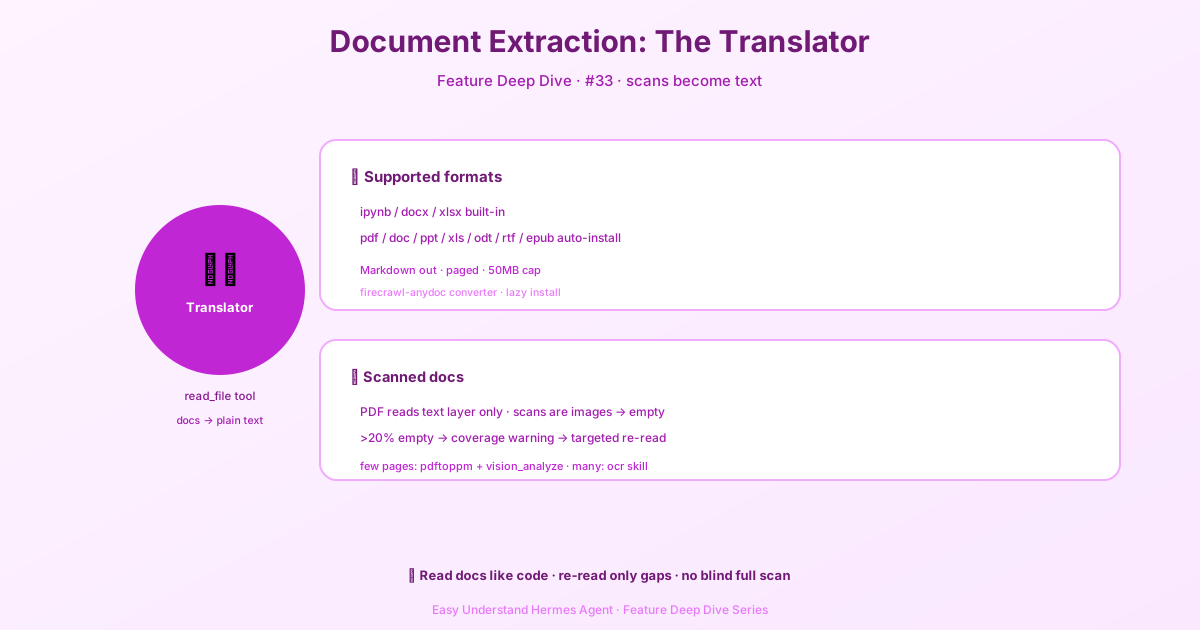
Três Formatos, Zero Configuração
Os formatos mais comuns funcionam de cara, sem necessidade de instalação:
- Jupyter notebooks (
.ipynb) - Documentos do Word (
.docx) - Planilhas do Excel (
.xlsx)
Eles são convertidos para texto Markdown e suportam leitura paginada via parâmetros offset e limit — como folhear um livro, página por página.
Todo o Resto: Instalação Automática, Sem Preocupações
Para PDFs, arquivos Office legados (.doc, .ppt, .xls), OpenDocument e ebooks (.epub), o Hermes instala automaticamente um conversor chamado firecrawl-anydoc no primeiro uso. Você não precisa fazer nada.
Um aviso: se a configuração do seu sistema desabilitar a instalação automática (security.allow_lazy_installs definido como false), apenas os três formatos nativos funcionam — todo o resto é tratado como binário. Além disso, arquivos acima de 50MB são rejeitados para evitar tempos de processamento excessivamente longos.
Funciona Também em Ambientes Remotos
Seja no Docker, Modal ou um servidor remoto via SSH, os arquivos são transferidos automaticamente de volta para sua máquina local para conversão. Ler um documento em um sandbox funciona exatamente como ler localmente.
O Grande Alerta: Scans São “PDFs Falsos”
Aqui está a pegadinha: a conversão de PDF só lê a camada de texto. Se um PDF é um scan (contratos em papel, faxes, documentos assinados), é tudo imagem — sem camada de texto — e o resultado é vazio.
O Hermes detecta isso de forma inteligente: se mais de 20% das páginas não geram texto (ou mais de 10 páginas em números absolutos), ele adiciona um aviso mostrando quais páginas estão vazias e o último texto que apareceu antes delas.
Por exemplo:
[AVISO DE COBERTURA DE EXTRAÇÃO: 198 de 311 páginas neste PDF não geraram texto...
  páginas 42-77 (36 páginas) — após "Antigua Maintenance Corp Bylaws" (p41)
  páginas 92-213 (122 páginas) — após "... Covenants, Codes and Regulations" (p91)]
Duas Maneiras de Resolver
Caso 1: Apenas algumas páginas são scans — Use renderização + visão. Converta essas páginas em imagens:
pdftoppm -jpeg -r 150 -f 92 -l 94 document.pdf /tmp/pageDepois use a ferramenta vision_analyze para “olhar” as imagens. Isso requer as ferramentas poppler instaladas no seu sistema (que o Hermes já usa para detecção, aliás).
Caso 2: A maioria das páginas são scans — Use OCR para reconhecimento em lote. O Hermes tem uma skill ocr-and-documents baseada em marker-pdf, que suporta mais de 90 idiomas e lida com fórmulas e tabelas. Ela precisa de 3–5GB de espaço em disco para instalar.
Resumo
read_file permite que a IA leia quase todos os formatos de documentos comuns — mas lembre-se: um PDF precisa de uma camada de texto para ser lido diretamente. Conselho prático: se você lida regularmente com scans, instale a skill de OCR antecipadamente. Se você só encontra algumas páginas escaneadas de vez em quando, use pdftoppm para converter imagens + análise de visão. Não faça a IA fazer OCR de um documento inteiro às cegas — leia o aviso primeiro, processe apenas as páginas realmente em branco e economize tempo e esforço.
📖 Documentação oficial
この記事は Hermes Agent のDocumentação oficialに基づいています:Documentação oficial › user-guide/features/document-extraction