Извлечение документов — сканы в текст
Извлечение документов — сканы в текст — простое для понимания руководство на основе официальной документации
Представьте: вы передаёте коллеге договор, а он листает его и говорит: «Тут сплошные картинки, я ни слова прочитать не могу». Именно эту проблему мы сегодня и решаем. Инструмент Hermes Agent read_file теперь умеет «открывать» файлы по-человечески — превращая PDF, документы Word, таблицы Excel и даже устаревшие офисные форматы в обычный текст, который он действительно понимает.
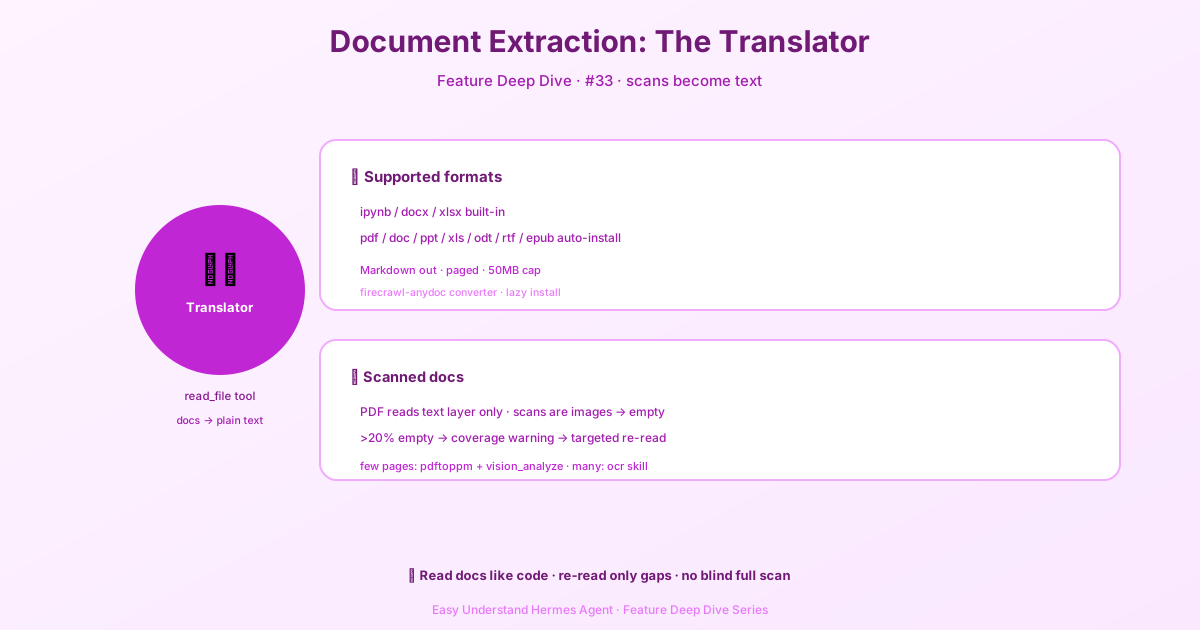
Три формата — ноль настройки
Самые распространённые форматы работают «из коробки», без установки чего-либо:
- Блокноты Jupyter (
.ipynb) - Документы Word (
.docx) - Таблицы Excel (
.xlsx)
Они конвертируются в текст Markdown и поддерживают чтение постранично через параметры offset и limit — как будто листаете книгу, страница за страницей.
Всё остальное: установится само, без забот
Для PDF, устаревших офисных файлов (.doc, .ppt, .xls), OpenDocument и электронных книг (.epub) Hermes автоматически установит конвертер под названием firecrawl-anydoc при первом использовании. Вам и пальцем пошевелить не нужно.
Один нюанс: если в вашей системной конфигурации отключена автоустановка (security.allow_lazy_installs установлено в false), будут работать только три встроенных формата — всё остальное будет обрабатываться как двоичные данные. Также файлы размером более 50 МБ отклоняются, чтобы избежать чрезмерно долгой обработки.
Работает и в удалённых средах
Работает ли ваш код на Docker, Modal или удалённом SSH-сервере — файлы автоматически передаются обратно на ваш локальный компьютер для конвертации. Чтение документа в песочнице ничем не отличается от чтения локально.
Большое предупреждение: сканы — это «фальшивые PDF»
Вот в чём ловушка: конвертация PDF читает только текстовый слой. Если PDF — это скан (бумажные договоры, факсы, подписанные документы), то там только изображения — нет текстового слоя — и результат будет пустым.
Hermes распознаёт это интеллектуально: если более 20% страниц не содержат текста (или более 10 страниц в абсолютном выражении), он добавляет предупреждение, показывающее, какие страницы пустые и какой последний текст был перед ними.
Например:
[ПРЕДУПРЕЖДЕНИЕ О ПОКРЫТИИ ИЗВЛЕЧЕНИЯ: 198 из 311 страниц этого PDF не содержат текста...
  страницы 42-77 (36 стр.) — после «Устав Antigua Maintenance Corp» (стр. 41)
  страницы 92-213 (122 стр.) — после «... Соглашения, Кодексы и Правила» (стр. 91)]
Два способа это исправить
Случай 1: Только несколько страниц — сканы — Используйте рендеринг + зрение. Конвертируйте эти страницы в изображения:
pdftoppm -jpeg -r 150 -f 92 -l 94 document.pdf /tmp/pageЗатем используйте инструмент vision_analyze, чтобы «посмотреть» на изображения. Для этого на вашей системе должны быть установлены инструменты poppler (которые Hermes в любом случае использует для обнаружения).
Случай 2: Большинство страниц — сканы — Используйте OCR для пакетного распознавания. У Hermes есть навык ocr-and-documents на основе marker-pdf, поддерживающий более 90 языков и работающий с формулами и таблицами. Для установки ему требуется 3–5 ГБ дискового пространства.
Резюме
read_file позволяет ИИ читать почти все распространённые форматы документов — но помните: PDF должен иметь текстовый слой, чтобы его можно было прочитать напрямую. Практический совет: если вы регулярно работаете со сканами, установите OCR-навык заранее. Если вам изредка попадаются несколько отсканированных страниц, используйте pdftoppm для конвертации в изображения + анализ через зрение. Не заставляйте ИИ вслепую прогонять через OCR весь документ — сначала прочитайте предупреждение, обработайте только действительно пустые страницы и сэкономьте и время, и силы.
📖 Официальная документация
Эта статья основана на официальной документации Hermes Agent :Официальные документы › user-guide/features/document-extraction