ドキュメント抽出 — スキャンからテキストへ
ドキュメント抽出 — スキャンからテキストへ — 公式ドキュメントに基づく分かりやすいガイド
想像してみてください。同僚に契約書を渡したら、ペラペラめくって「これ、全部画像じゃん。一文字も読めないよ」と言われた経験はありませんか? まさに今日、私たちはその問題を解決します。Hermes Agentのread_fileツールは、人間と同じようにファイルを「開く」ことができるようになりました。PDF、Word文書、Excelシート、さらにはレガシーなOfficeファイルまで、AIが実際に理解できるプレーンテキストに変換します。
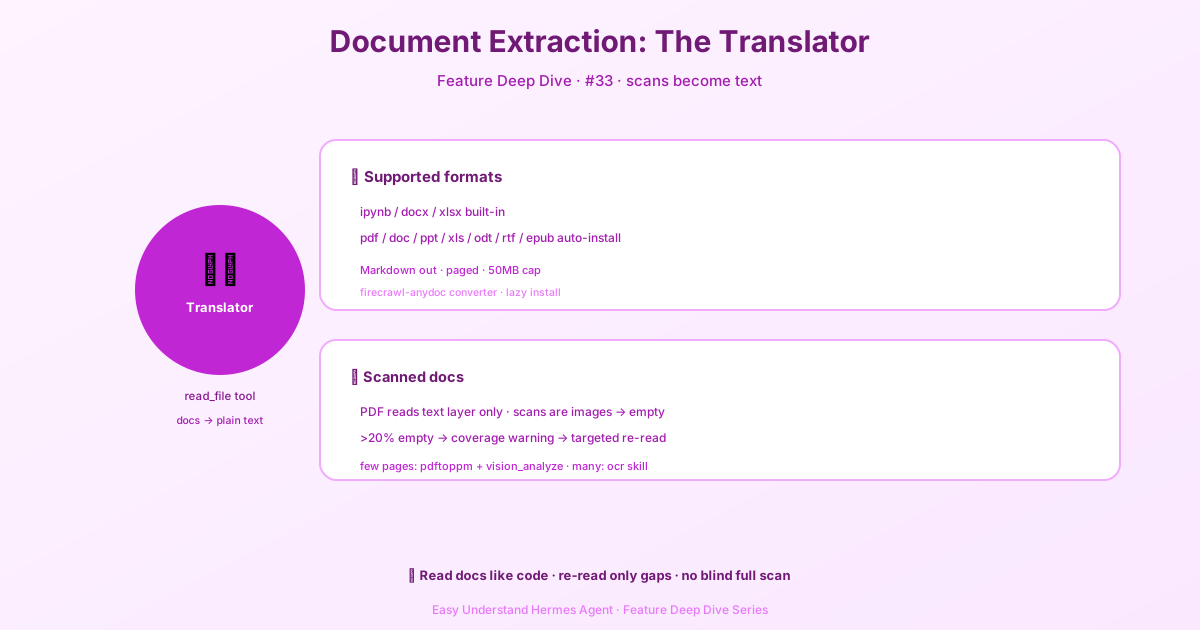
3つのフォーマットは、セットアップ不要
最も一般的なフォーマットは、追加インストールなしですぐに使えます:
- Jupyterノートブック (
.ipynb) - Word文書 (
.docx) - Excelスプレッドシート (
.xlsx)
これらはMarkdownテキストに変換され、offsetパラメータとlimitパラメータによるページ送り読み取りに対応しています。まるで本をページごとにめくるように。
その他の形式:自動インストールで、何も心配いりません
PDF、レガシーOfficeファイル (.doc, .ppt, .xls)、OpenDocument、電子書籍 (.epub) については、Hermesが初回使用時にfirecrawl-anydocというコンバーターを自動的にインストールします。あなたが何か操作する必要は一切ありません。
1つだけ注意点:システム設定で自動インストールが無効になっている場合(security.allow_lazy_installsがfalse)、組み込みの3形式のみが機能し、それ以外はバイナリとして扱われます。また、処理時間が長くなりすぎるのを防ぐため、50MBを超えるファイルは拒否されます。
リモート環境でも動作します
コードがDocker、Modal、SSHリモートサーバーのいずれで実行されている場合でも、ファイルは変換のために自動的にローカルマシンに転送されます。サンドボックス内でのドキュメント読み取りは、ローカルでの読み取りとまったく同じように機能します。
大きな警告:スキャン文書は「偽物のPDF」
ここが落とし穴です:PDF変換はテキストレイヤーのみを読み取ります。PDFがスキャン文書(紙の契約書、FAX、署名済み文書)の場合、すべて画像であり、テキストレイヤーが存在しないため、結果は空になります。
Hermesはこれをインテリジェントに検出します:ページの20%以上(または絶対数で10ページ以上)からテキストが得られなかった場合、どのページが空であるか、そしてその前に表示されていた最後のテキストを示す警告を先頭に追加します。
例えば:
[抽出範囲警告: このPDFの311ページ中198ページからテキストが得られませんでした...
  42〜77ページ (36ページ) — 「Antigua Maintenance Corp Bylaws」(p41) の後
  92〜213ページ (122ページ) — 「... Covenants, Codes and Regulations」(p91) の後]
2つの修正方法
ケース1: スキャン文書が数ページだけの場合 — レンダリング+ビジョンを使用します。それらのページを画像に変換します:
pdftoppm -jpeg -r 150 -f 92 -l 94 document.pdf /tmp/page次に、vision_analyzeツールを使用して画像を「視覚的に」確認します。これには、システムにpopplerツールがインストールされている必要があります(Hermesは検出のためにそもそもこれを使用します)。
ケース2: ほとんどのページがスキャン文書の場合 — バッチ認識にはOCRを使用します。Hermesには、marker-pdfベースのocr-and-documentsスキルがあり、90以上の言語をサポートし、数式や表も処理できます。インストールには3〜5GBのディスク容量が必要です。
まとめ
read_fileを使用すると、AIはほぼすべての一般的なドキュメント形式を読み取ることができます。ただし、覚えておいてください:PDFを直接読み取るには、テキストレイヤーが必要です。実用的なアドバイス:スキャン文書を頻繁に扱う場合は、事前にOCRスキルをインストールしておきましょう。たまに数ページのスキャン文書に遭遇するだけの場合は、pdftoppmで画像に変換してビジョン分析を使用します。AIに文書全体を盲目的にOCR処理させないでください。まず警告を読み、実際に空白のページのみを処理することで、時間と労力を節約できます。
📖 公式ドキュメント
この記事は Hermes Agent の公式ドキュメントに基づいています:公式ドキュメント › user-guide/features/document-extraction