شغّل Hermes مع Ollama مجانًا
شغّل Hermes مع Ollama مجانًا — دليل سهل الفهم يستند إلى الوثائق الرسمية
فكّر في Hermes Agent كمساعد ذكي، وOllama كعقله المحلي المجاني — معًا يشكّلان ثنائيًا قويًا دون أن تنفق فلسًا واحدًا على الذكاء الاصطناعي السحابي.
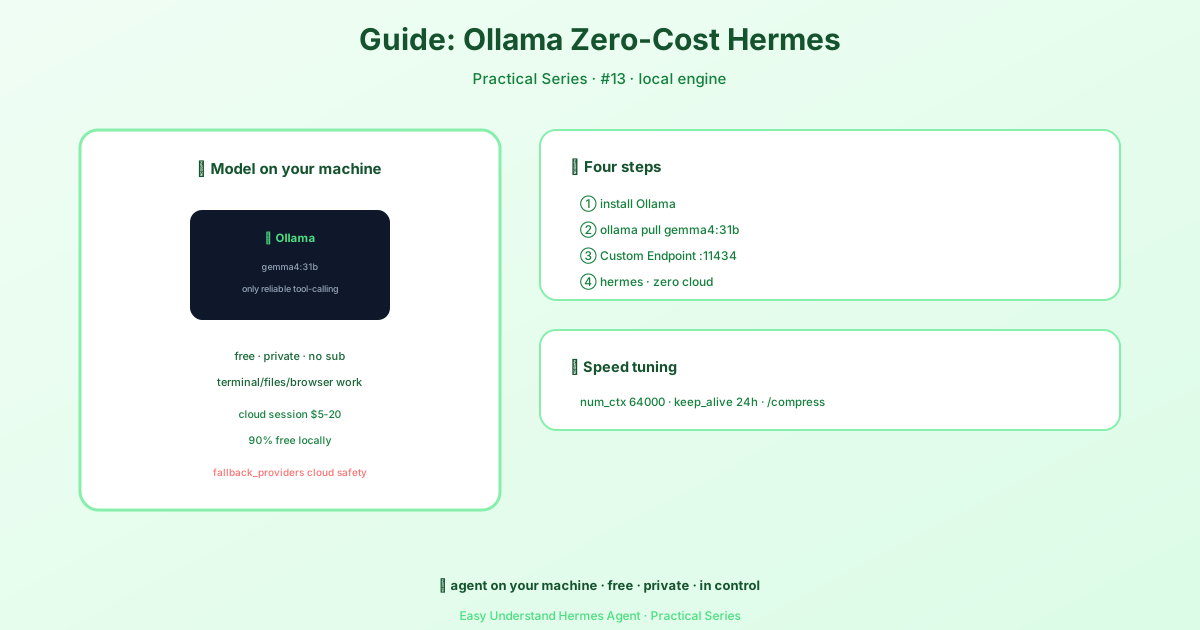
ما الذي ستحتاجه
- Hermes Agent (إطار عمل المساعد)
- Ollama (يشغّل نماذج الذكاء الاصطناعي على جهازك)
- Docker (اختياري، لكنه يسهّل الإعداد)
الخطوة 1: تثبيت Ollama
أولًا، حمّل وثبّت Ollama من ollama.com. ثم اسحب نموذجًا:
ollama pull llama3.2هذا يُحمّل نموذجًا صغيرًا وسريعًا يعمل بشكل رائع مع Hermes.
الخطوة 2: تشغيل Ollama
شغّل Ollama كخادم حتى يتمكن Hermes من التواصل معه:
ollama serveافتراضيًا، يستمع Ollama على المنفذ 11434. أبقِ نافذة الطرفية هذه مفتوحة.
الخطوة 3: ربط Hermes بـ Ollama
إذا كنت تشغّل Hermes على جهازك (وليس داخل Docker)، أنشئ ملف إعدادات في ~/.hermes/config.yaml:
model:
  provider: custom
  model: llama3.2
  base_url: http://127.0.0.1:11434/v1
  api_key: "none"
مهم: يجب أن يطابق اسم model تمامًا ما سحبته سابقًا.
الخطوة 4: تشغيل Hermes
الآن شغّل Hermes:
docker run -d \
  --name hermes \
  --network host \
  -v ~/.hermes:/opt/data \
  nousresearch/hermes-agent gateway run
ملاحظة: استخدام
--network hostعلى لينكس يتيح لـ Hermes رؤية Ollama على127.0.0.1. على ماك/ويندوز، استخدمhost.docker.internal:11434بدلًا من ذلك.
الخطوة 5: اختبره
تحقق من أن Hermes يمكنه الوصول إلى Ollama:
docker exec hermes curl -s http://127.0.0.1:11434/v1/modelsيجب أن ترى قائمة تحتوي على llama3.2. إذا لم يحدث ذلك، تأكد من أن Ollama ما زال يعمل.
نصائح لحل المشكلات
- لا يمكن الاتصال؟ تأكد من أن Ollama يستمع على
0.0.0.0وليس فقط127.0.0.1. شغّلOLLAMA_HOST=0.0.0.0 ollama serveإذا لزم الأمر. - النموذج غير موجود؟ يجب أن يطابق الاسم في إعداداتك تمامًا ما سحبته.
- تعارض في المنفذ؟ غيّر منفذ Ollama باستخدام
OLLAMA_PORT=11435وحدّث إعداداتك.
لماذا هذا رائع
- مجاني للأبد — لا فواتير API
- خصوصية تامة — بياناتك تبقى على جهازك
- يعمل دون إنترنت — لا حاجة لاتصال بالشبكة
نصيحة أخيرة
ابدأ بنموذج صغير مثل llama3.2 (3B) لاختبار أن كل شيء يعمل. بعد أن تعتاد على الأمر، جرّب نماذج أكبر مثل qwen2.5:7b للحصول على ردود أفضل — فقط تذكر تحديث اسم model في إعداداتك.
أصبح لديك الآن مساعد ذكاء اصطناعي محلي ومجاني بالكامل يعمل مع Hermes وOllama. بناء سعيد!
📖 التوثيق الرسمي
この記事は Hermes Agent のالتوثيق الرسميに基づいています:التوثيق الرسمي › guides/local-ollama-setup