Execute o Hermes com Ollama gratuitamente
Execute o Hermes com Ollama gratuitamente — guia fácil de entender baseado na documentação oficial
Pense no Hermes Agent como um assistente inteligente, e no Ollama como o cérebro local e gratuito dele — juntos, formam uma dupla poderosa sem gastar nada com IA na nuvem.
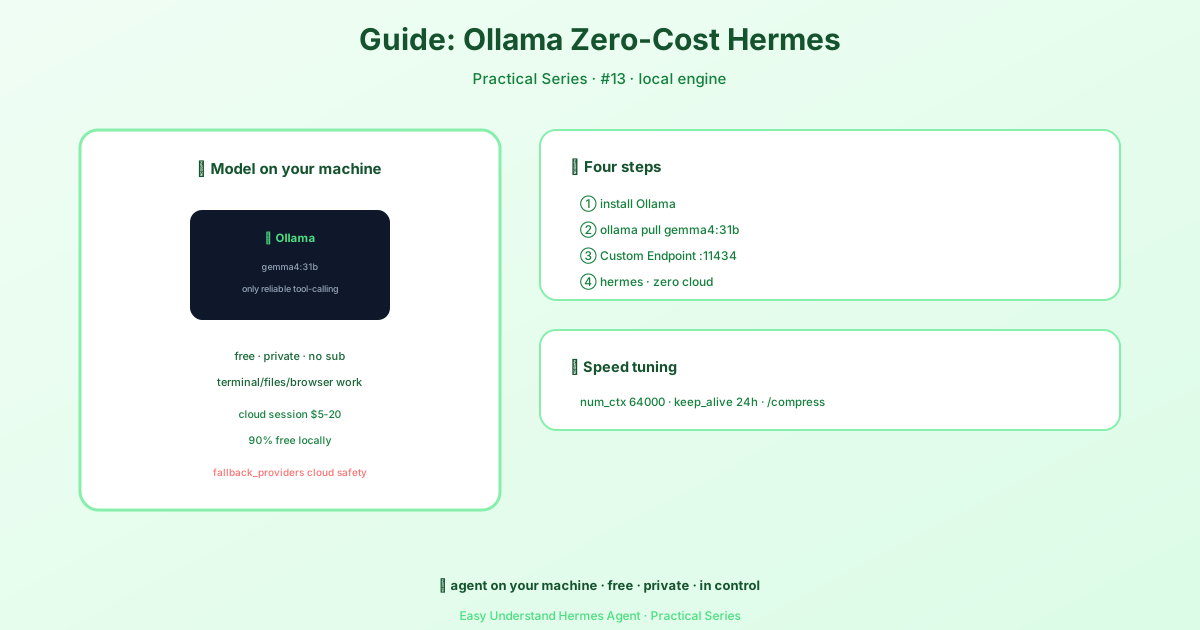
O Que Você Precisa
- Hermes Agent (o framework assistente)
- Ollama (roda modelos de IA no seu computador)
- Docker (opcional, mas facilita a configuração)
Passo 1: Instale o Ollama
Primeiro, baixe e instale o Ollama em ollama.com. Depois, baixe um modelo:
ollama pull llama3.2Isso baixa um modelo pequeno e rápido que funciona muito bem com o Hermes.
Passo 2: Execute o Ollama
Inicie o Ollama como um servidor para que o Hermes possa conversar com ele:
ollama servePor padrão, o Ollama escuta na porta 11434. Mantenha esta janela do terminal aberta.
Passo 3: Conecte o Hermes ao Ollama
Se você estiver rodando o Hermes no seu computador (fora do Docker), crie um arquivo de configuração em ~/.hermes/config.yaml:
model:
  provider: custom
  model: llama3.2
  base_url: http://127.0.0.1:11434/v1
  api_key: "none"
Importante: O nome do model deve corresponder exatamente ao que você baixou anteriormente.
Passo 4: Execute o Hermes
Agora inicie o Hermes:
docker run -d \
  --name hermes \
  --network host \
  -v ~/.hermes:/opt/data \
  nousresearch/hermes-agent gateway run
Nota: Usar
--network hostno Linux permite que o Hermes veja o Ollama em127.0.0.1. No Mac/Windows, usehost.docker.internal:11434em vez disso.
Passo 5: Teste
Verifique se o Hermes consegue acessar o Ollama:
docker exec hermes curl -s http://127.0.0.1:11434/v1/modelsVocê deve ver uma lista com llama3.2. Se não aparecer, confira se o Ollama ainda está rodando.
Dicas de Solução de Problemas
- Não consegue conectar? Certifique-se de que o Ollama está escutando em
0.0.0.0, não apenas em127.0.0.1. ExecuteOLLAMA_HOST=0.0.0.0 ollama servese necessário. - Modelo não encontrado? O nome no seu arquivo de configuração deve corresponder exatamente ao que você baixou.
- Conflito de porta? Mude a porta do Ollama com
OLLAMA_PORT=11435e atualize sua configuração.
Por Que Isso é Incrível
- Grátis para sempre — sem contas de API
- Privado — seus dados ficam na sua máquina
- Funciona offline — funciona sem internet
Dica Final
Comece com um modelo pequeno como llama3.2 (3B) para testar se tudo funciona. Quando se sentir confortável, experimente modelos maiores como qwen2.5:7b para respostas melhores — só lembre de atualizar o nome do model na sua configuração.
Agora você tem um assistente de IA totalmente local e gratuito rodando com Hermes e Ollama. Bons builds!
📖 Documentação oficial
この記事は Hermes Agent のDocumentação oficialに基づいています:Documentação oficial › guides/local-ollama-setup