รัน Hermes ด้วย Ollama ฟรี
รัน Hermes ด้วย Ollama ฟรี — คู่มือเข้าใจง่ายอ้างอิงจากเอกสารอย่างเป็นทางการ
ลองนึกภาพว่า Hermes Agent เป็นผู้ช่วยอัจฉริยะ และ Ollama เป็นสมองท้องถิ่นที่ฟรี — เมื่ออยู่ด้วยกัน พวกมันคือคู่หูที่ทรงพลังโดยไม่ต้องเสียเงินแม้แต่บาทเดียวกับบริการ AI บนคลาวด์
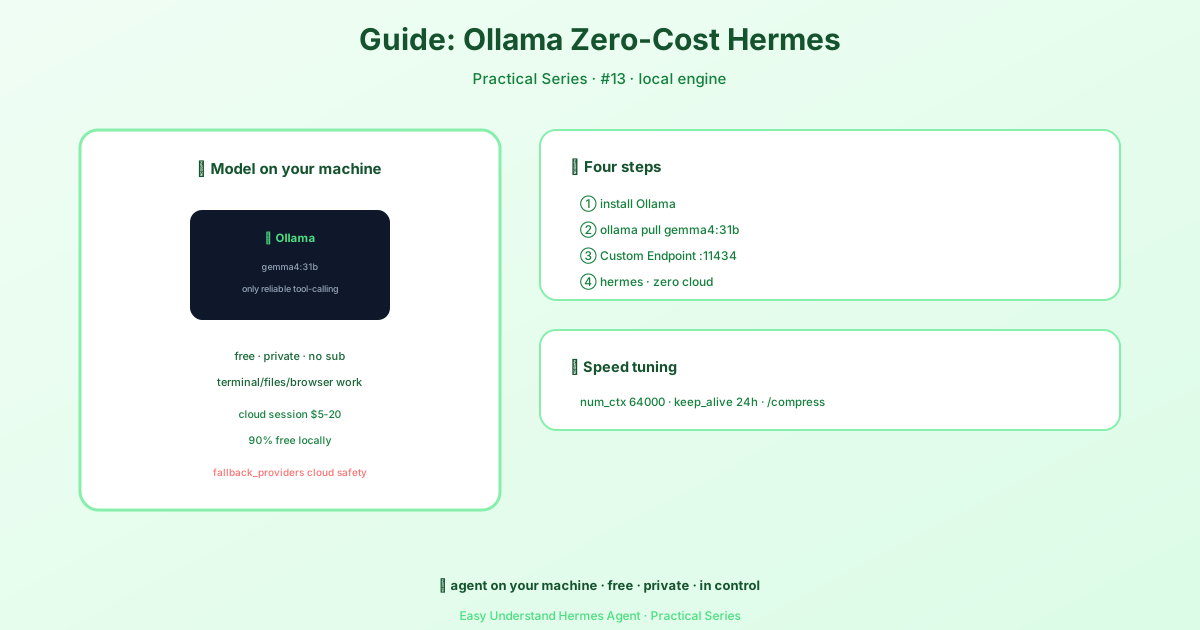
สิ่งที่คุณต้องมี
- Hermes Agent (เฟรมเวิร์กผู้ช่วย)
- Ollama (รันโมเดล AI บนคอมพิวเตอร์ของคุณ)
- Docker (ไม่จำเป็น แต่ทำให้การติดตั้งง่ายขึ้น)
ขั้นตอนที่ 1: ติดตั้ง Ollama
ก่อนอื่น ให้ดาวน์โหลดและติดตั้ง Ollama จาก ollama.com จากนั้นดึงโมเดลมาใช้:
ollama pull llama3.2คำสั่งนี้จะดาวน์โหลดโมเดลขนาดเล็กที่ทำงานเร็ว และเข้ากันได้ดีกับ Hermes
ขั้นตอนที่ 2: รัน Ollama
เริ่มรัน Ollama ในโหมดเซิร์ฟเวอร์ เพื่อให้ Hermes สามารถสื่อสารกับมันได้:
ollama serveโดยค่าเริ่มต้น Ollama จะฟังที่พอร์ต 11434 เปิดหน้าต่างเทอร์มินัลนี้ไว้
ขั้นตอนที่ 3: เชื่อมต่อ Hermes กับ Ollama
หากคุณรัน Hermes บนคอมพิวเตอร์ของคุณ (ไม่ได้อยู่ใน Docker) ให้สร้างไฟล์คอนฟิกที่ ~/.hermes/config.yaml:
model:
  provider: custom
  model: llama3.2
  base_url: http://127.0.0.1:11434/v1
  api_key: "none"
สำคัญ: ชื่อ model ต้องตรงกับที่คุณดึงมาเมื่อกี้ทุกตัวอักษร
ขั้นตอนที่ 4: รัน Hermes
จากนั้นเริ่มรัน Hermes:
docker run -d \
  --name hermes \
  --network host \
  -v ~/.hermes:/opt/data \
  nousresearch/hermes-agent gateway run
หมายเหตุ: การใช้
--network hostบน Linux จะทำให้ Hermes เห็น Ollama ที่127.0.0.1บน Mac/Windows ให้ใช้host.docker.internal:11434แทน
ขั้นตอนที่ 5: ทดสอบ
ตรวจสอบว่า Hermes สามารถเข้าถึง Ollama ได้:
docker exec hermes curl -s http://127.0.0.1:11434/v1/modelsคุณควรเห็นรายการที่มี llama3.2 หากไม่เห็น ให้ตรวจสอบอีกครั้งว่า Ollama ยังรันอยู่
เคล็ดลับการแก้ไขปัญหา
- เชื่อมต่อไม่ได้? ตรวจสอบให้แน่ใจว่า Ollama กำลังฟังที่
0.0.0.0ไม่ใช่แค่127.0.0.1รันOLLAMA_HOST=0.0.0.0 ollama serveหากจำเป็น - ไม่พบโมเดล? ชื่อในคอนฟิกของคุณต้องตรงกับที่คุณดึงมาเป๊ะๆ
- พอร์ตชนกัน? เปลี่ยนพอร์ตของ Ollama ด้วย
OLLAMA_PORT=11435และอัปเดตคอนฟิกของคุณ
ทำไมถึงเจ๋ง
- ฟรีตลอดไป — ไม่มีบิลค่า API
- เป็นส่วนตัว — ข้อมูลของคุณอยู่บนเครื่องคุณ
- ใช้งานแบบออฟไลน์ได้ — ทำงานได้โดยไม่ต้องใช้อินเทอร์เน็ต
เคล็ดลับสุดท้าย
เริ่มต้นด้วยโมเดลเล็กๆ อย่าง llama3.2 (3B) เพื่อทดสอบว่าทุกอย่างทำงานได้ เมื่อชินแล้ว ลองใช้โมเดลใหญ่ขึ้นอย่าง qwen2.5:7b เพื่อคำตอบที่ดีขึ้น — แค่อย่าลืมอัปเดตชื่อ model ในคอนฟิกของคุณ
ตอนนี้คุณมีผู้ช่วย AI ท้องถิ่นที่ฟรีและสมบูรณ์แบบ รันด้วย Hermes และ Ollama แล้ว ขอให้สนุกกับการสร้างสรรค์!
📖 เอกสารทางการ
この記事は Hermes Agent のเอกสารทางการに基づいています:เอกสารทางการ › guides/local-ollama-setup