Nous Tool Gateway — 300+ Models
Nous Tool Gateway — 300+ Models — easy-to-understand guide based on official docs
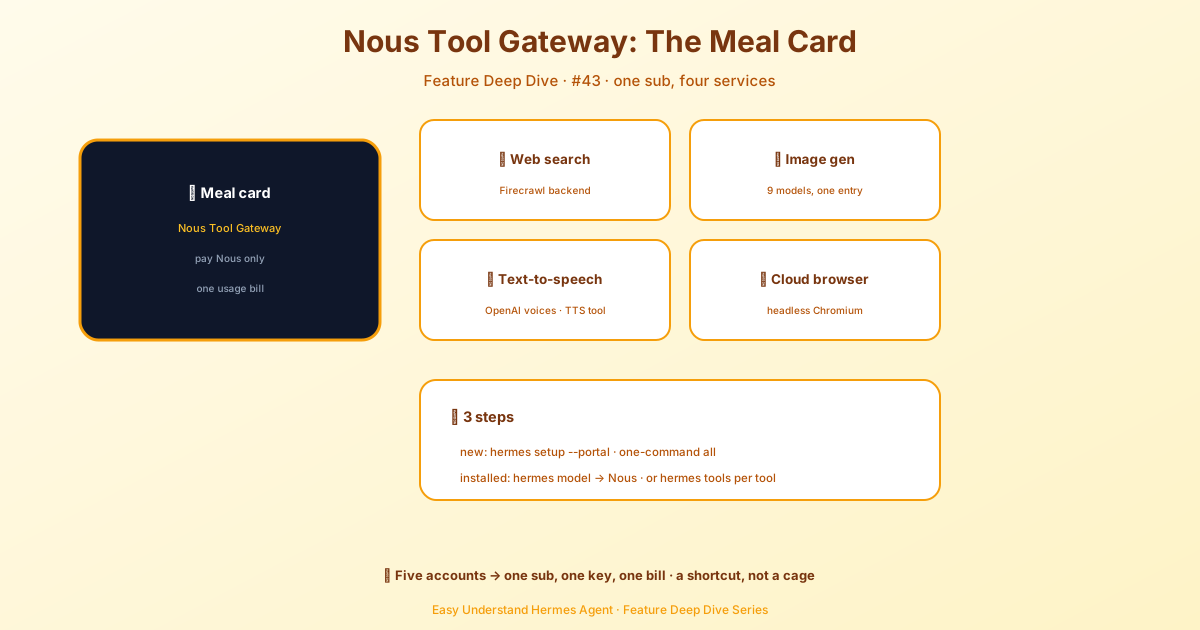
Nous Tool Gateway — 300+ modèles
Salut les builders d’agents ! 👋
La dernière fois, on parlait du Nous Tool Gateway et de la façon dont il débloque plus de 300 modèles avec un seul abonnement. Aujourd’hui, on passe à la pratique : comment configurer ces modèles dans Hermes.
Voyez les choses comme ça : votre agent a un cerveau (le modèle principal) et une bande de petits assistants (les modèles auxiliaires). Le cerveau gère toute la réflexion — chaque message, chaque appel d’outil, chaque réponse. Les assistants s’occupent des tâches secondaires comme résumer des pages web, analyser des images ou compresser de longues conversations.
Voyons comment configurer les deux, de la manière la plus simple.
Le chemin le plus rapide : Nous Portal
Si vous partez d’une installation fraîche, voici une commande qui fait tout :
hermes setup --portalÇa vous connecte à Nous Portal et le définit comme fournisseur en une seule commande. Vous voulez voir ce qui est branché ? Lancez :
hermes portal infoOh, et petit bonus sympa : les abonnés Portal bénéficient de 10 % de réduction sur les fournisseurs facturés aux tokens. De vraies économies si vous mélangez les fournisseurs.
Petite note sur le paramètre model:
Sur une nouvelle installation, votre config contient model: "" — une chaîne vide signifiant « pas encore configuré ». La première fois que vous lancez hermes setup ou hermes model, cette clé se transforme en un mapping complet avec provider, default, base_url et api_mode.
Si vous revoyez cette chaîne vide un jour, lancez simplement hermes model (ou cliquez sur Changer dans le dashboard) et Hermes s’en occupera.
La page Modèles
Ouvrez votre dashboard et cliquez sur Modèles dans la barre latérale. Vous verrez deux sections :
- Paramètres des modèles — où vous assignez des modèles aux emplacements
- Analytique d’utilisation — des cartes classées montrant chaque modèle ayant exécuté une session, avec les compteurs de tokens, les coûts et les badges de capacités
La carte du haut est votre panneau Paramètres des modèles. La ligne principale montre ce que votre agent utilisera pour les nouvelles sessions. Cliquez sur Changer pour ouvrir le sélecteur.
Définir le modèle principal
Le sélecteur a deux colonnes :
- Gauche — vos fournisseurs authentifiés (uniquement ceux configurés avec des clés API ou OAuth)
- Droite — la liste de modèles organisée pour le fournisseur sélectionné
Voici la partie cool : Hermes ne vous montre pas le dump brut de /models (qui sur OpenRouter inclut plus de 400 modèles, y compris TTS et générateurs d’images). À la place, vous obtenez une liste organisée de modèles agentiques — ceux qui sont réellement bons en raisonnement et en utilisation d’outils.
Tapez dans le champ de filtre pour affiner, choisissez un modèle, cliquez sur Changer, et Hermes l’écrit dans ~/.hermes/config.yaml.
Important : Cela s’applique uniquement aux nouvelles sessions. Vos onglets de chat ouverts continuent avec le modèle avec lequel ils ont démarré. Pour changer à chaud le chat en cours, utilisez la commande slash /model à l’intérieur.
Changements en cours de session : un mot de prudence
Changer de modèle en pleine conversation ? Hermes vous avertira si votre prochain message risque de déclencher une compression de contexte par rapport à la fenêtre du nouveau modèle. Le changement s’applique quand même immédiatement, mais la compression s’exécute sur votre premier message après le changement.
Voici le vrai piège : les caches de prompt sont liés au modèle. Donc tout changement en cours de conversation signifie que le message suivant relit toute la conversation au prix fort au lieu du tarif en cache (environ 75 à 90 % de réduction). Sur une longue session, cette relecture unique peut coûter plus cher que la différence par token entre les modèles.
Conseil de pro : Changez de modèle tôt dans une conversation, ou juste après avoir démarré une nouvelle session.
Niveaux d’entraînement de données sans supervision
Certains modèles (comme muse-spark-1.2-contributor) sont remisés parce que le fournisseur peut s’entraîner sur vos données. La sélection interactive de modèles affiche toujours une confirmation. Mais pour les charges de travail sans supervision (workers Kanban, agents cron), Hermes échoue en mode sécurisé car il ne peut pas vous demander.
Si vous êtes d’accord, enregistrez une confirmation persistante :
hermes config set security.allow_data_training_tiers_noninteractive trueHermes affiche toujours l’avertissement complet sur la politique de données à chaque démarrage, donc vos logs gardent une piste d’audit. Révoquez avec :
hermes config unset security.allow_data_training_tiers_noninteractiveDéfinir les modèles auxiliaires
Cliquez sur Afficher les auxiliaires pour révéler les 11 emplacements de tâches. Chaque tâche auxiliaire est par défaut sur auto — ce qui signifie qu’Hermes essaie aussi votre modèle principal pour ce travail. Si cela échoue, il suit une chaîne de repli, puis les fournisseurs de repli principaux, puis la découverte intégrée d’Hermes.
Remplacez une tâche spécifique quand vous voulez un modèle moins cher ou plus rapide pour une tâche secondaire. Par exemple, vous pourriez vouloir un tout petit modèle pour la génération de titres de session, mais votre meilleur modèle pour les tâches de vision.
Pour conclure
Voilà pour la visite guidée de la configuration des modèles ! Que vous utilisiez les 300+ modèles de Nous Portal ou que vous mélangiez vos propres fournisseurs, Hermes vous donne un contrôle fin sur ce qui pense et ce qui aide.
La prochaine fois, on creusera les bonnes pratiques des modèles auxiliaires — quelles tâches bénéficient de modèles plus petits, et lesquelles ont vraiment besoin du gros cerveau. Restez branchés ! 🚀
📖 Documentation officielle
Cet article est basé sur la documentation officielle de Hermes Agent :Docs officiels › user-guide/features/tool-gateway